拖慢Solana應用程式的十個迷思:為什麼高速設定仍然會慢
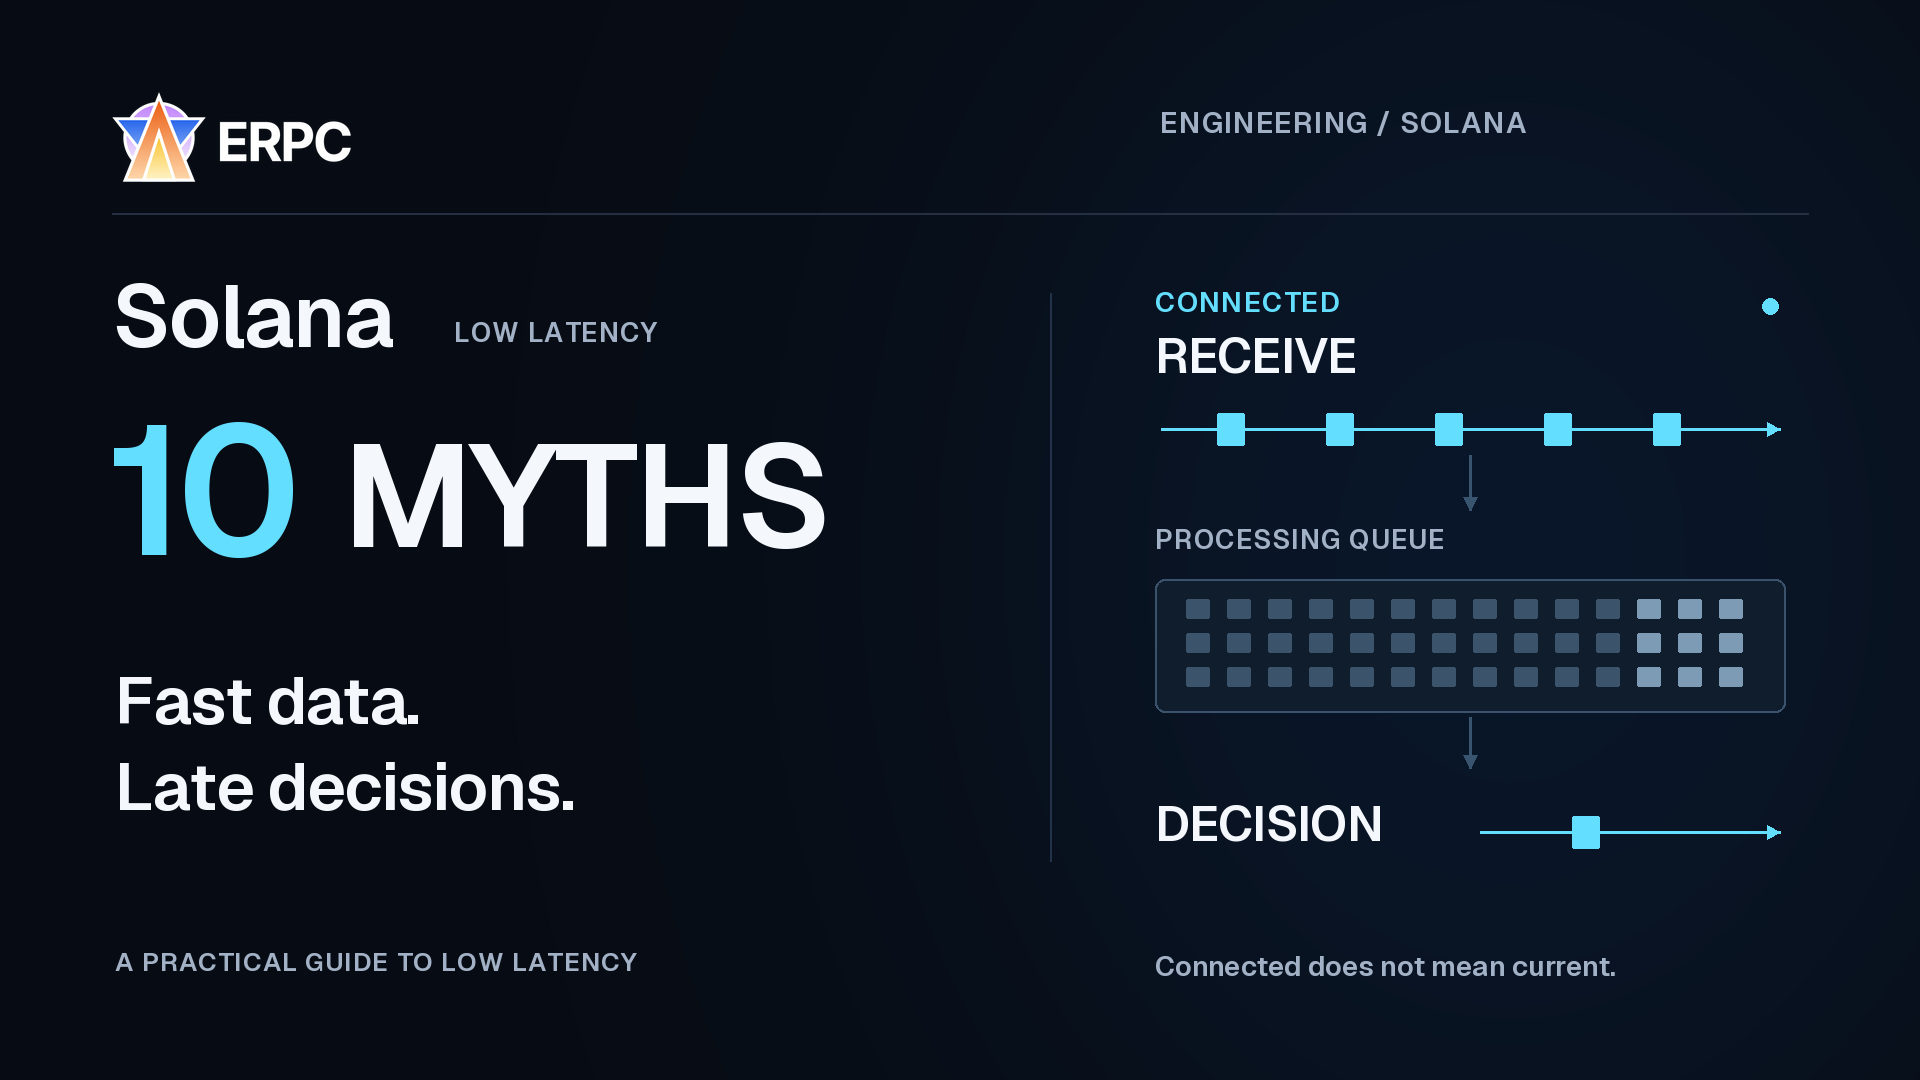
連線速度很快,CPU也很新,伺服器甚至與資料提供方位於同一座城市。然而,應用程式對所需資訊的反應依然遲緩。連線沒有斷開,正在處理的資料卻逐漸落後於最新狀態。
在Solana上開發低延遲應用程式時,這種情況未必只有一個原因。網路路由、接收設定、訂閱的資料,以及應用程式內部的等待,可能共同限制所選高速基礎設施的效能發揮。
ERPC由ELSOUL LABO B.V.營運。我們的支援團隊反覆遇到接收迴圈停滯、用戶端設定、訂閱範圍過寬,以及未解決原始錯誤就不斷重新連線等問題。在傳統Web應用程式中影響不大的選擇,到了高頻交易和即時處理場景,可能就會成為瓶頸。
本文梳理這些問題背後的十個迷思,幫助你同時檢查基礎設施的選擇,以及將其效能傳遞到決策和交易提交環節的設計。
首先明確:希望哪件事更早完成
網路往返時間、資料到達時間、決策時間,以及交易得到確認所需的時間,是不同的指標。如果收到資料後的處理停滯,ping再快也無法讓決策及時完成。RPC回應迅速,也不意味著交易已經執行。
先定義目標,例如從觀察到目標事件,到完成必要決策並提交交易的時間。然後分別測量觀察、接收後的處理,以及提交與確認。改善的起點,是不再用單個產品名稱或單一數字概括速度。
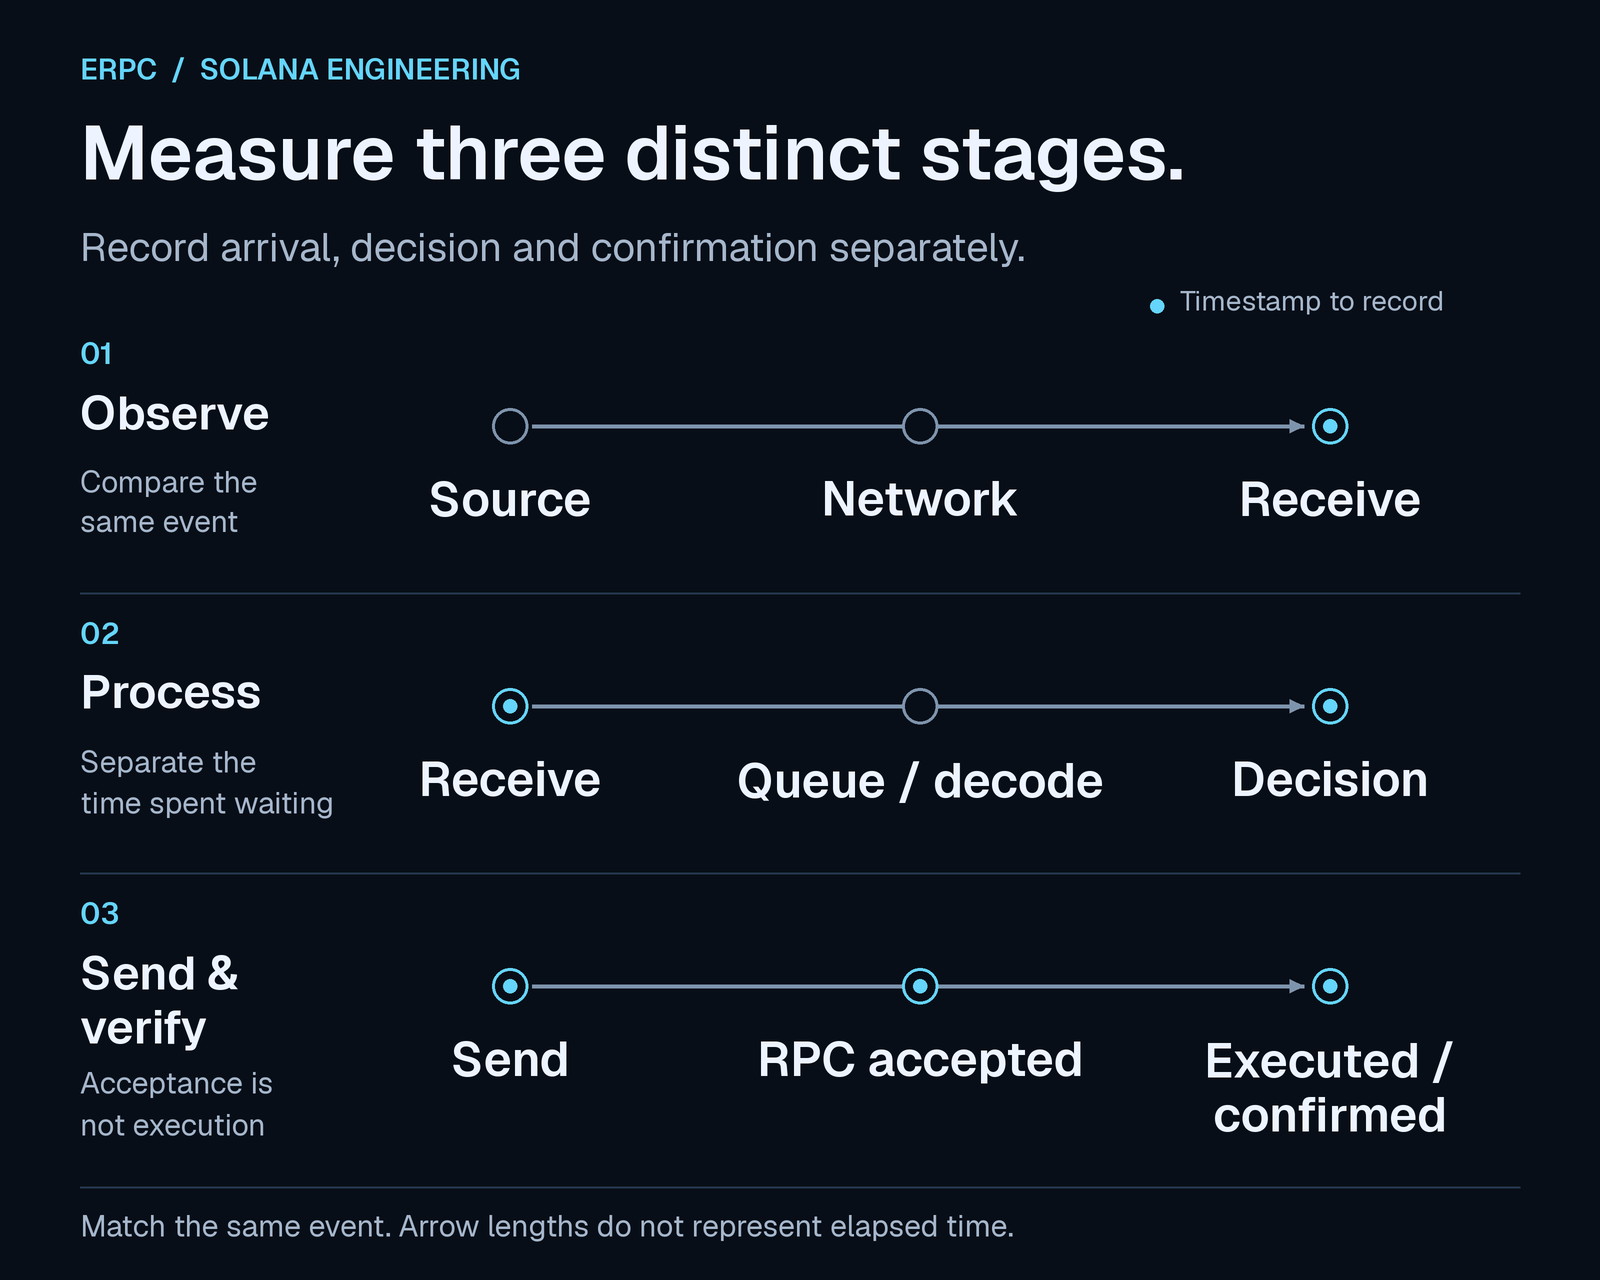
此圖用於說明測量階段,不代表各階段的實測耗時或效能差異。
迷思1:小型VM能執行,就說明效能足夠
小型雲端VM曾經很好地承載了某個Web應用程式或Ethereum工作負載,這種經驗容易讓人認為,相同設定也能處理Solana資料串流。但偶爾發起RPC查詢的應用程式,與持續接收、處理大範圍更新的應用程式,所需資源並不相同。
應根據資料量、到達速率、每個事件的處理工作和可接受延遲確定環境規模。每秒會收到多少事件?傳輸多少位元組?解碼和決策消耗多少CPU時間與記憶體?除了正常流量,還要預留應對突發流量的餘量。即使在同一條鏈上,訂閱範圍與實作方式也會改變資源需求。
難點在於,資源不足的應用程式可能看起來仍在正常工作。螢幕持續顯示資料,內容卻越來越陳舊;重新連線期間的缺口也可能沒有被發現。只看接收事件數無法識別這些問題。還應檢查處理完成的事件數、未處理資料的等待時間,以及訂閱應覆蓋事件的連續性。
如果只參照過去的經驗,開發者可能始終不懷疑接收端的處理能力,而持續將問題歸因於資料端點。嘗試資源更充裕的環境,有時能暴露之前沒有察覺的積壓或資料缺漏。
排查時,在資源更充裕的接收與處理環境中,使用相同端點、訂閱、commitment、SDK及設定,以及相同處理任務進行比較。保持區域一致,記錄CPU、記憶體和網路的差異,並比較接收吞吐量、完成的工作量、積壓、缺漏事件和決策耗時。工作負載會隨時間變化,因此應儘可能在同一時段比較,同時遵守連線數限制,控制對服務施加的負載。
更換環境後有所改善,說明接收或處理條件對結果存在影響。如果CPU、記憶體和網路同時發生變化,還需要進一步檢查才能確定起作用的資源。按照實際處理的資料量與到達速率選擇資源,是低延遲處理的前提。
迷思2:位於同一城市,網路距離就一定近
“都在Frankfurt,所以肯定很近。”“部署在Tokyo,對日本使用者一定最快。”城市名稱有助於篩選部署位置,但不能保證流量實際經過的路徑。
路徑取決於資料中心之間的連線、網路營運商之間的連線,以及路由選擇。即使伺服器位於同一城市,通訊也可能繞經外部網路。例如,RIPE IPmap將流量離開某個國家後又返回等低效路由的視覺化,列為其用途之一。[1]
應測量實際資料來源與執行應用程式的主機之間的RTT、隨時間變化的波動、重傳或封包遺失,以及同一事件的到達時間。Traceroute和MTR能幫助調查路徑,但不能僅憑跳數判斷哪條路徑更好。也不能把中間路由器限制診斷回應,直接認定為影回應用程式的封包丟失。
選定區域後,再問一步:這個具體的資料來源與這臺具體的伺服器,實際上如何連線?這項額外檢查能夠揭示城市名稱無法說明的差異。
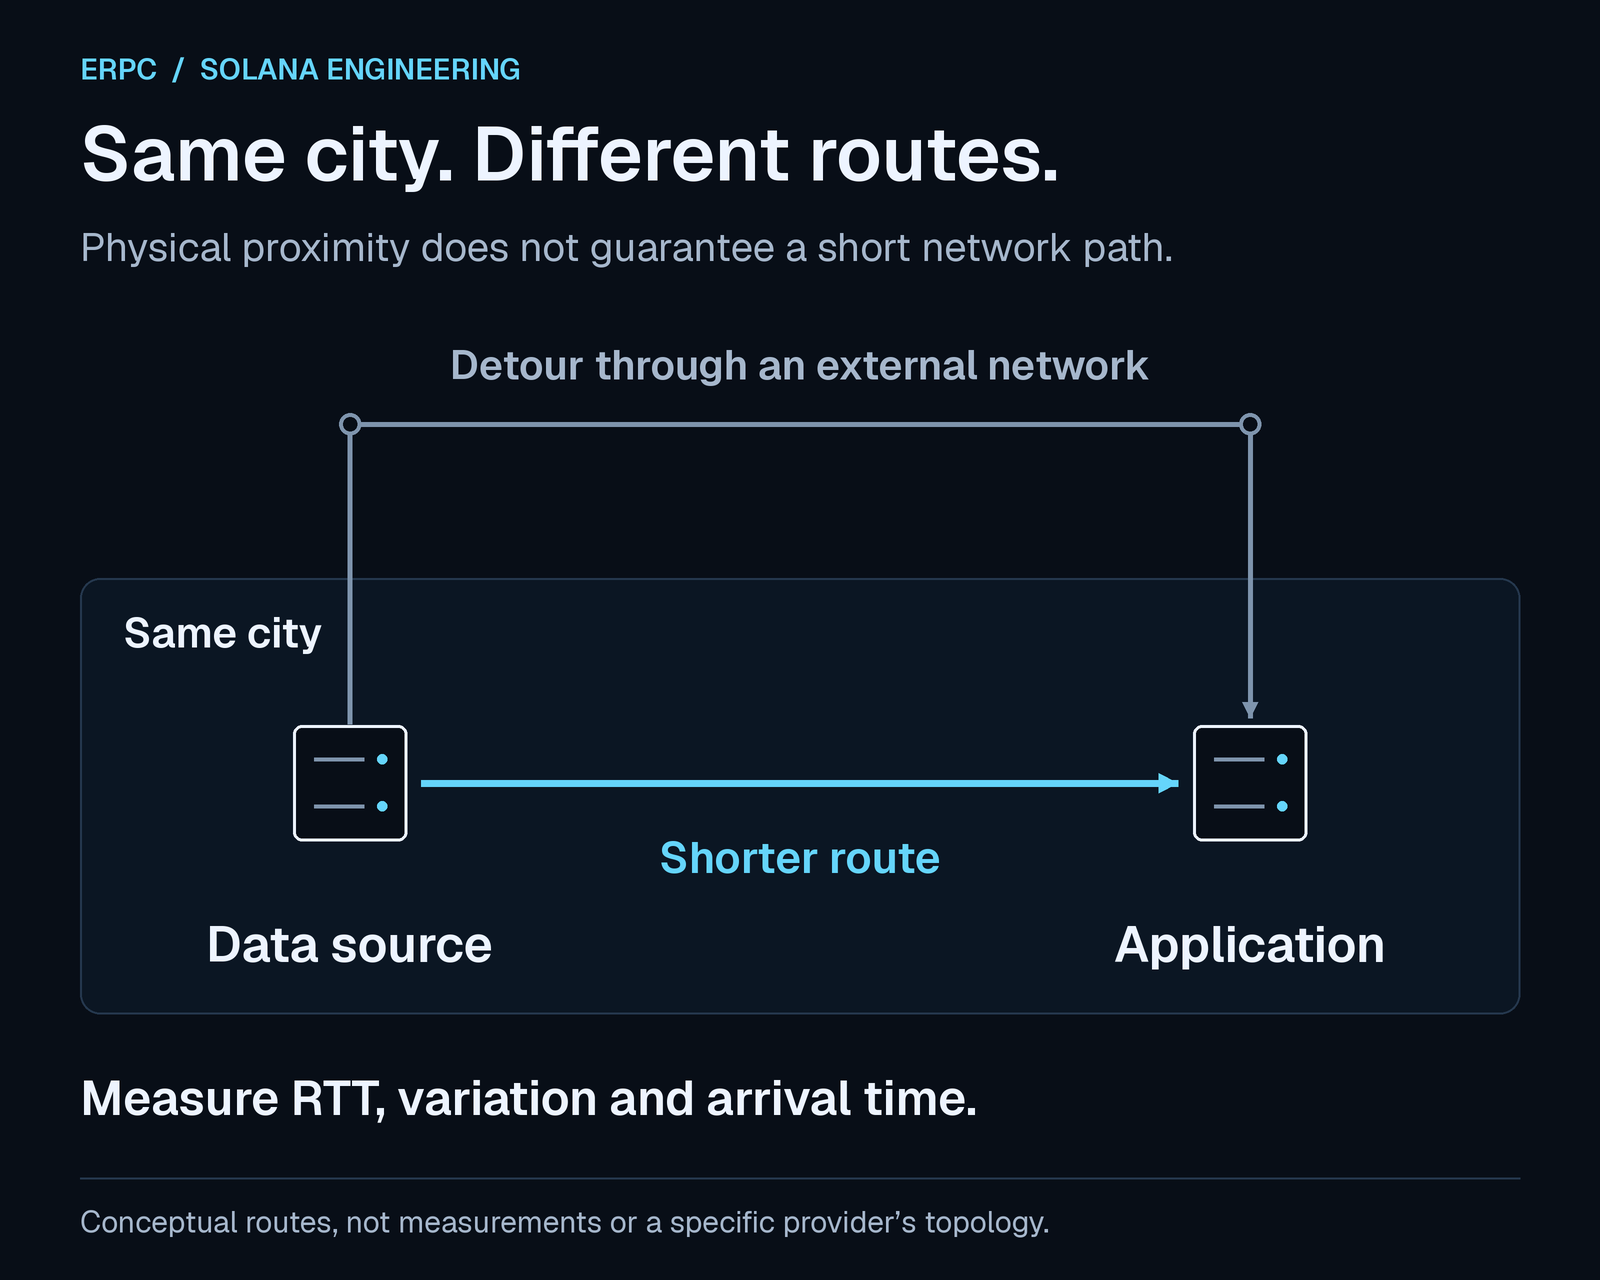
此圖用於解釋路由差異,並非任何特定服務商的實際網路。
迷思3:網路規格高,可用頻寬就一定充足
伺服器規格中的頻寬可能指不同內容:實體連接埠速率、分配給虛擬機器的頻寬、持續頻寬,或臨時突發上限。配備高速網路卡,並不意味著應用程式能持續用滿其全部容量。
例如,AWS文件區分基準頻寬與突發頻寬,並說明與流量目的地、流和封包速率有關的限制。這是理解規格的例子,不代表所有VPS都具有與AWS相同的限制。[2]
選擇方案時,要確認頻寬是獨享還是共享、持續使用的條件、流量額度,以及不同流量目的地是否受到不同待遇。測試時,應使用計劃在正式環境中採用的相同端點和訂閱條件持續通訊,並同時觀察接收吞吐量、封包遺失、重傳和CPU負載。
短時間測速得到高分,不能證明伺服器能夠持續處理正式環境的資料串流。同時,接收吞吐量低也不一定意味著頻寬不足。升級網路前,應先區分接收設定問題與處理能力限制。
迷思4:CPU型號更好、核心更多、最大GHz更高,應用程式就快
CPU的最高加速時脈,不是它在所有工作負載下都會維持的時脈。實際執行受功耗、溫度、韌體、頻率控制和其他負載影響。Linux文件也解釋了,啟用boost只是允許使用加速功能,不代表CPU當時確實處於加速狀態。[3]
如果關鍵工作集中在一個執行緒中,僅增加核心數不會讓該工作更早完成。總體CPU使用率看似很低時,某個核心或事件迴圈仍可能已經飽和。Node.js官方指南也說明了重型回呼如何讓其他工作等待。[4]
應在實際負載下檢查時脈、溫度、各核心使用率和處理耗時。在虛擬環境中,等待CPU分配的時間也有參考價值。透過效能分析,確認解碼、計算、記憶體分配和日誌輸出各自消耗了多少時間。
需要綜合選擇CPU時脈效能、資源分配、可持續發揮效能的設定和應用程式實作。只比較型號,無法確定整個應用程式的執行速度。
迷思5:使用gRPC,用戶端預設設定就足夠
建立gRPC連線,不代表能夠以所需速度接收所需資料量。HTTP/2透過流量控制,由接收方告知傳送方可以接收多少資料。控制同時存在於流和連線兩個層級,因此即使網路鏈路尚有餘量,接收視窗及其更新也可能限制吞吐量。[5][6]
接收視窗告知傳送方,在接收方再次更新之前,最多可以傳送多少資料。初始值、自動調整和設定優先順序因SDK與程式庫而異。在設定檔案裡寫入一個大數值,並不能證明用戶端按預期執行。要檢查流和連線兩個層級的設定、它們與自適應設定的關係,以及所用版本。
調整時,應在相同訂閱條件下測量實際接收吞吐量和處理積壓。單條訊息的最大接收大小、TCP接收緩衝區,以及HTTP/2接收視窗,是不同的設定。Keepalive檢查連線是否存活,並不會增加處理能力或頻寬。
ERPC gRPC FAQ提供了排查步驟和用戶端設定示例,適用於吞吐量持平而延遲不斷增加的資料串流。可以將示例作為起點,再根據自身訂閱量與處理能力驗證。[7]
迷思6:接收所有完整區塊,就能最早作出判斷
“先接收全部資料,再尋找有用資訊。”這是開始開發時容易理解的方式,但也會增加作出判斷前並不需要的工作。傳輸、解碼、為無關資料分配記憶體並進行搜尋,都會消耗有限的頻寬和CPU資源。
如果希望回應某個市場、程式或帳戶的變化,應先定義決策所需的事件和欄位。Yellowstone gRPC提供交易與帳戶訂閱篩選器,也能只取得部分帳戶資料。完整區塊通知與單條更新通知,本身也是不同的資料形式。[8]
在資源與條件相同的情況下,如果一個應用程式等待全部記錄展開並搜尋完畢,另一個應用程式能立即處理必要更新,後者就省去了這段等待。專注於特定目標的競爭者反覆更早回應,原因可能不只在網路連線。決定哪些資訊可以忽略,也是低延遲設計的一部分。
索引、審計、研究和歷史儲存可能確實需要全量資料。應為這類負載提供獨立路徑。將它與即時決策分離,可以分別設計所需的處理能力和完整性。不過,必須驗證篩選沒有排除正確決策所需的更新。批處理在某些情況下也能提高總吞吐量,應根據應用程式可容忍的等待時間選擇。
在ERPC當前的Shared gRPC服務中,非空的
blocks訂閱需要Dedicated服務。transactions訂閱或blocksMeta可能滿足特定需求,但兩者提供的資料都不等同於完整區塊。選擇Dedicated服務後,仍需具備合適的接收端處理能力和訂閱設計。[9]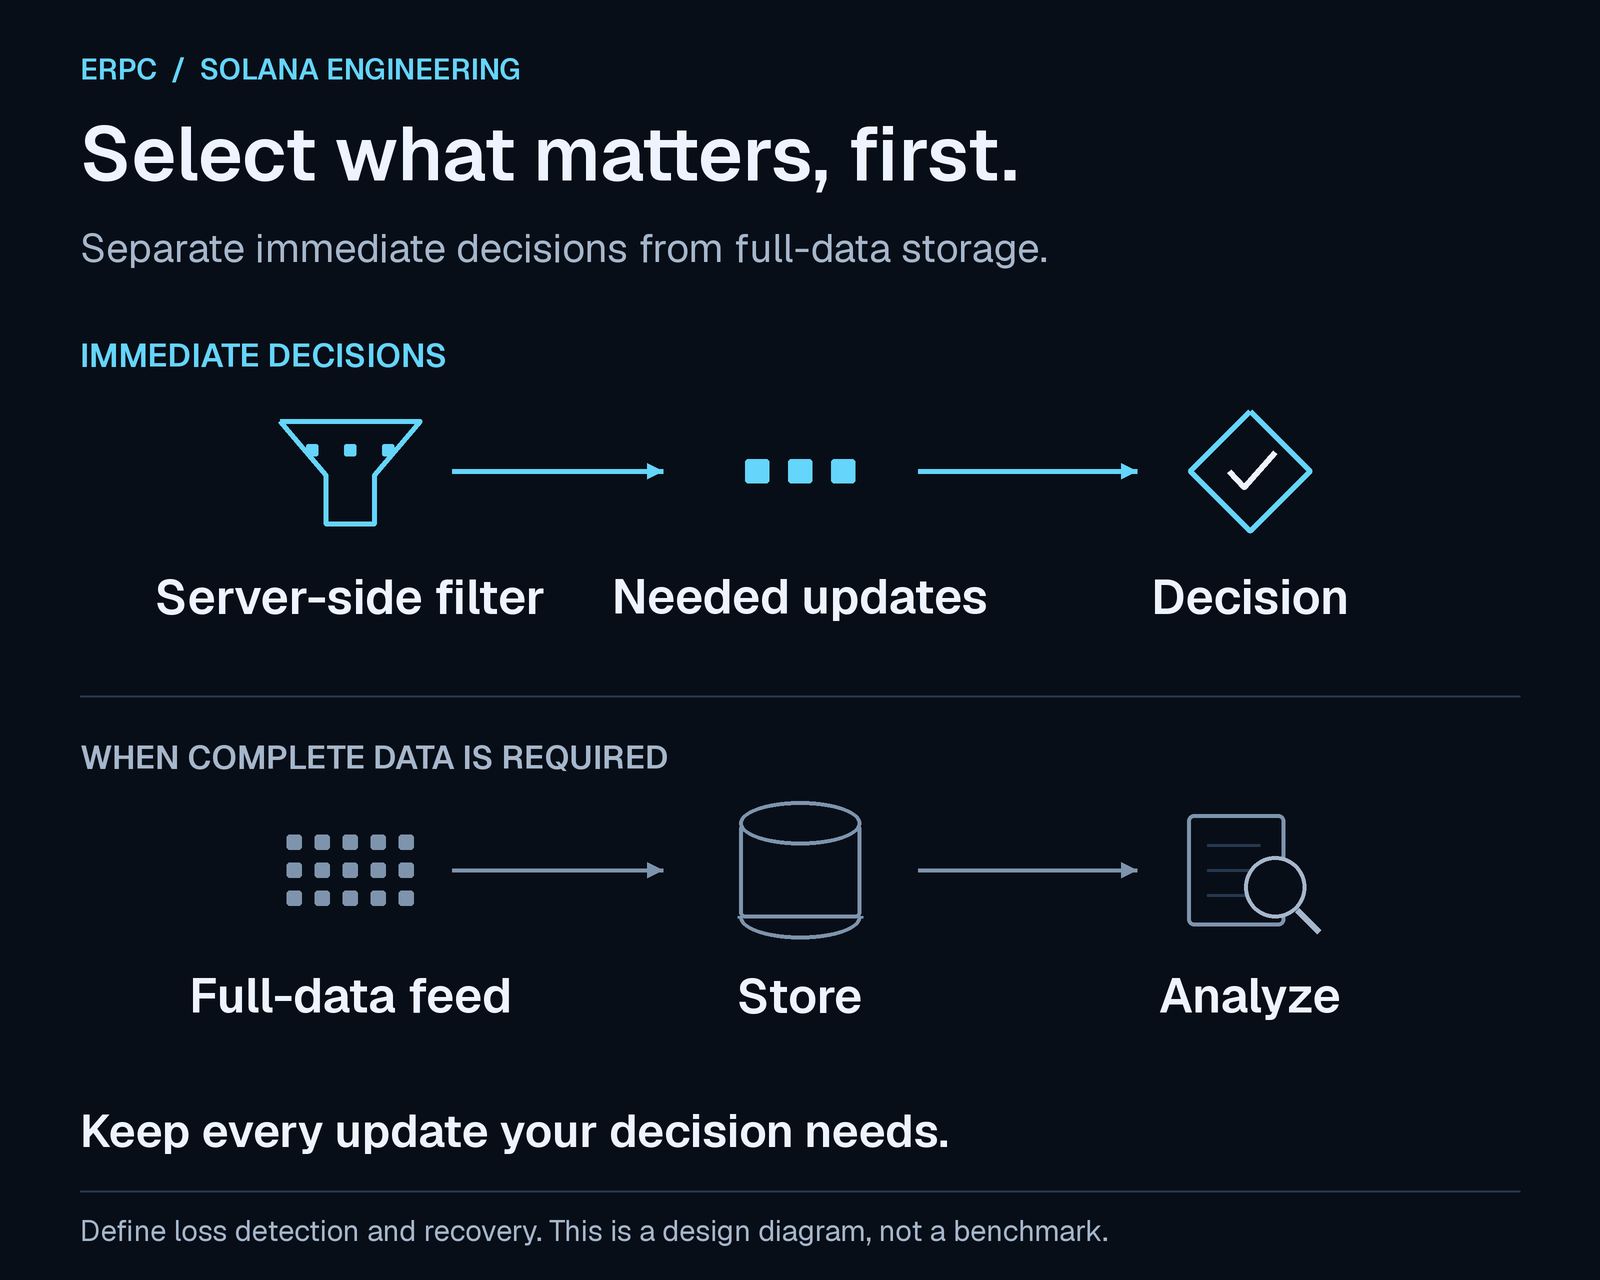
此圖說明一種架構設計方式。縮小訂閱範圍時,應同時定義決策所需資訊,以及資料缺漏後的恢復方式。
迷思7:資料一直在到達,處理就一定跟得上
從資料被接收,到處理成可供決策使用的狀態之間,可能形成佇列。如果持續流入的工作超過處理能力,即使連線保持暢通,延遲也會累積。更大的緩衝區可以吸收短時突發,但面對持續的處理不足,只會容納更多舊資料。
不要只測量收到的事件數。還要測量完成處理量、佇列長度、最早一條未處理資料的等待時間,以及從接收到決策結束的時間。連線健康與資料新鮮度應分開監控。
接收迴圈中只保留維持接收所需的工作。考慮將資料庫寫入、完整內容的日誌、外部API呼叫和重型計算分到其他處理路徑。為佇列設定容量上限,以及佇列滿時的處理策略。有界佇列填滿後仍會讓上游工作等待;它本身不能解決處理能力不足。[10]
對於只關心最新狀態的更新,有時可以合併舊狀態。但要求按順序處理或完整處理的交易事件,不能任意丟棄。應根據應用程式需求設計缺口偵測、重放和重新連線後的狀態恢復。
ERPC的
STREAM_GUARD_SLOW_READER是針對寫入進展不足或觀測到傳遞延遲而採取的保護回應。不能僅據此認定原因。需要檢查連線、主機、訂閱量,以及應用程式的消費速率。重新連線前,應保留能夠取得的首次status、message、metadata和trailers,再閱讀伺服器提供的原因與重試條件。未修正就重新傳送相同的被拒請求,原始原因仍然存在。[7]迷思8:ping或平均值很快,關鍵時刻就會快
Ping能提供網路往返時間的參考。它測量的區間不同於應用程式延遲,後者還包括資料來源處理、訂閱內容、接收等待、解碼和決策。平均值也可能掩蓋少數較大的延遲。
p50是中位數。p95和p99分別表示95%和99%的測量值不超過的數值位置。p99不是最大值。應附上樣本數和測量時段,並檢查事件集中到達時的結果、最大值、超時、斷連和資料缺漏。[11]
比較提供方時,應匹配相同事件、資料型別、commitment和訂閱條件。儘可能在同一臺測量主機上接收,並用單調時鐘測量應用程式內部的經過時間。對來自不同主機的時間戳做減法時,要考慮時鐘偏差對測量的影響。
只保留成功事件,可能讓經常缺漏資料的設定看起來很快。選擇最快的一次結果,與選擇正式環境的關鍵時刻更不容易落後的設定,是不同的判斷。
迷思9:最早到達的資料,含義與最終確定性都相同
Shreds、交易通知、帳戶更新和區塊通知,並不代表同一階段的同一種資訊。使用更早階段的資料,可能需要應用程式自行完成更多重建或解釋。比較時,不僅要對齊接收時刻,還要對齊該時刻究竟能知道什麼。[8][12]
也要區分Solana的
processed、confirmed和finalized commitment級別。如果使用早期觀察結果作出決策,應用程式需要在之後檢查確認狀態,並在必要時修正自身狀態。接收早期更新,與在外部系統中採取確定性操作所需滿足的條件,應分開設計。[13]例如,簡單比較不同commitment下收到的通知,並宣稱其中一個快了多少毫秒,並不是在比較同一項工作。先確定應用程式所需的資訊與最終確定性,再測量在這些條件下達到可作出決策狀態所需的時間。
迷思10:提交成功,就會先執行
sendTransaction成功返回,意味著RPC接受了交易,不保證叢集已經處理或確認。Solana規範明確要求另外檢查交易簽名的狀態。[14]即使輸入資訊支援應用程式較早作出判斷,提交路徑、blockhash有效性、可寫帳戶競爭、計算資源、優先費,以及交易自身的成功條件,仍然影響結果。SWQoS涉及通向leader的准入和連線優先順序,優先費則影響排程優先順序。兩者角色不同,也都不會無條件保證執行順序或成功。[15][16]
應分別記錄決策完成、提交開始、RPC接受、執行結果,以及所需的確認狀態。重試時,也要區分重新傳送同一簽名的交易與構造新交易,以避免意外的重複操作。
只有能夠觀察從接收到確認的整條路徑,才能識別哪些改善會讓你更接近目標。
最先建立的測量項目
無需一次性實施所有最佳化。先在一致條件下記錄以下項目,便於判斷每次調整的效果。
| 階段 | 記錄內容 | 幫助識別的問題 |
|---|---|---|
| 網路與接收 | 實際接收吞吐量、重傳與丟失、同一事件的到達差 | 路由、頻寬和接收設定限制 |
| 應用程式 | 接收與處理完成數量、佇列長度、最早未處理資料的等待時間 | 持續處理不足和陳舊資料累積 |
| 決策耗時 | 接收到決策完成的p50、p95、p99與最大耗時 | 高成本工作和突發期間的延遲 |
| 提交與確認 | 提交開始、RPC接受、簽名狀態、執行錯誤 | 接收之後的延遲與失敗 |
| 比較條件 | 區域、主機、SDK及版本、訂閱、commitment、時段與樣本數 | 條件不同造成的表面差異 |
保留基線,然後根據症狀逐項驗證調整:訂閱範圍、處理分離、用戶端設定,以及部署位置或資源。擴大視窗時,也要檢查記憶體佔用和積壓是否增加。縮小訂閱範圍時,要確認必要資訊沒有丟失。
總耗時的p99,不能透過簡單相加各階段的p99得出。應根據每個對應事件的總耗時計算,再用分階段測量定位原因。除了平均負載,也要在實際的事件突發期間測試。
ERPC準備基礎設施,讓開發者專注打磨邏輯
網路、伺服器、資料傳遞和用戶端分別選擇時,即使每項規格都很好,組合後仍可能留下等待。ERPC將Solana資料傳遞與處理環境整合到同一平臺,減少開發者反覆從零選擇部署位置和資源的工作。
SUPER VPS和Premium VPS明確提供高時脈設定與不超額分配資源的設計,Bare Metal則提供實體專用機器。ERPC將網路與伺服器放在靠近傳遞環境的位置,並為持續處理準備CPU、記憶體、儲存和連線條件。具體規格可依方案與區域查詢。[17][18]
| 常見開發障礙 | ERPC提供的基礎設施與資訊 | 應用程式中需要打磨的內容 |
|---|---|---|
| 城市名稱無法揭示的距離 | 能夠一起選擇傳遞與處理環境的區域和網路設定 | 在自身訂閱條件下測量到達時間及波動 |
| 資源競爭與持續效能 | 不超額分配資源的高時脈SUPER VPS、Premium VPS,以及獨享Bare Metal | 找出高成本工作與循序處理 |
| 資料量與連線方式 | gRPC、Shreds、RPC,以及適合負載的共享或獨享選項 | 定義所需事件與欄位 |
| 接收設定與故障排查 | Solana Stream SDK、設定示例、篩選器文件和按錯誤分類的FAQ | 驗證實際生效設定、佇列、重新連線與恢復 |
ERPC幫助開發者推進基礎設施選擇與調校,讓更多時間用於開發:觀察什麼、用哪些資訊決策、何時提交。在選擇合適服務與部署位置後,讓訂閱量匹配處理能力,才能將基礎設施效能轉化為應用程式速度。
先確定決策真正需要哪些資訊,儘早接收,避免不必要的處理等待,並驗證結果。ERPC將持續提供支援這些改善的環境與資訊。
實作資源
- ERPC gRPC FAQ: https://erpc.global/zh-tw/faq/grpc/general/
- 訂閱篩選器與當前Shared限制: https://erpc.global/zh-tw/doc/geyser-grpc/filter/
- gRPC實作最佳實務: https://erpc.global/zh-tw/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/zh-tw/vps/
- ERPC Bare Metal: https://erpc.global/zh-tw/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Validators DAO官方Discord: https://discord.gg/C7ZQSrCkYR
技術參考資料
- RIPE IPmap,路由低效的視覺化: https://ipmap.ripe.net/
- AWS,執行個體網路頻寬: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel,CPU效能調節: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js,避免阻塞事件迴圈: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113,HTTP/2流量控制: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC,流量控制: https://grpc.io/docs/guides/flow-control/
- ERPC,gRPC FAQ中的接收設定、慢速接收端與重試: https://erpc.global/zh-tw/faq/grpc/general/
- Yellowstone gRPC,訂閱與篩選器規範: https://github.com/rpcpool/yellowstone-grpc
- ERPC,當前Shared篩選器規則: https://erpc.global/zh-tw/doc/geyser-grpc/filter/
- Tokio,佇列與背壓: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch,百分位數定義: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC,Shreds UDP Forwarding: https://erpc.global/zh-tw/doc/shredstream/udp-forwarding/
- Solana,交易確認與過期: https://solana.com/developers/cookbook/transactions/confirmation
- Solana,sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana,按質押權重分配服務品質: https://solana.com/docs/defi/stake-weighted-qos
- Solana,交易費用: https://solana.com/docs/core/fees
- ERPC,VPS設定與規格: https://erpc.global/zh-tw/vps/
- ERPC,Bare Metal設定與規格: https://erpc.global/zh-tw/baremetal/