Zehn Mythen, die Solana-Anwendungen ausbremsen: Warum eine schnelle Umgebung trotzdem langsam sein kann
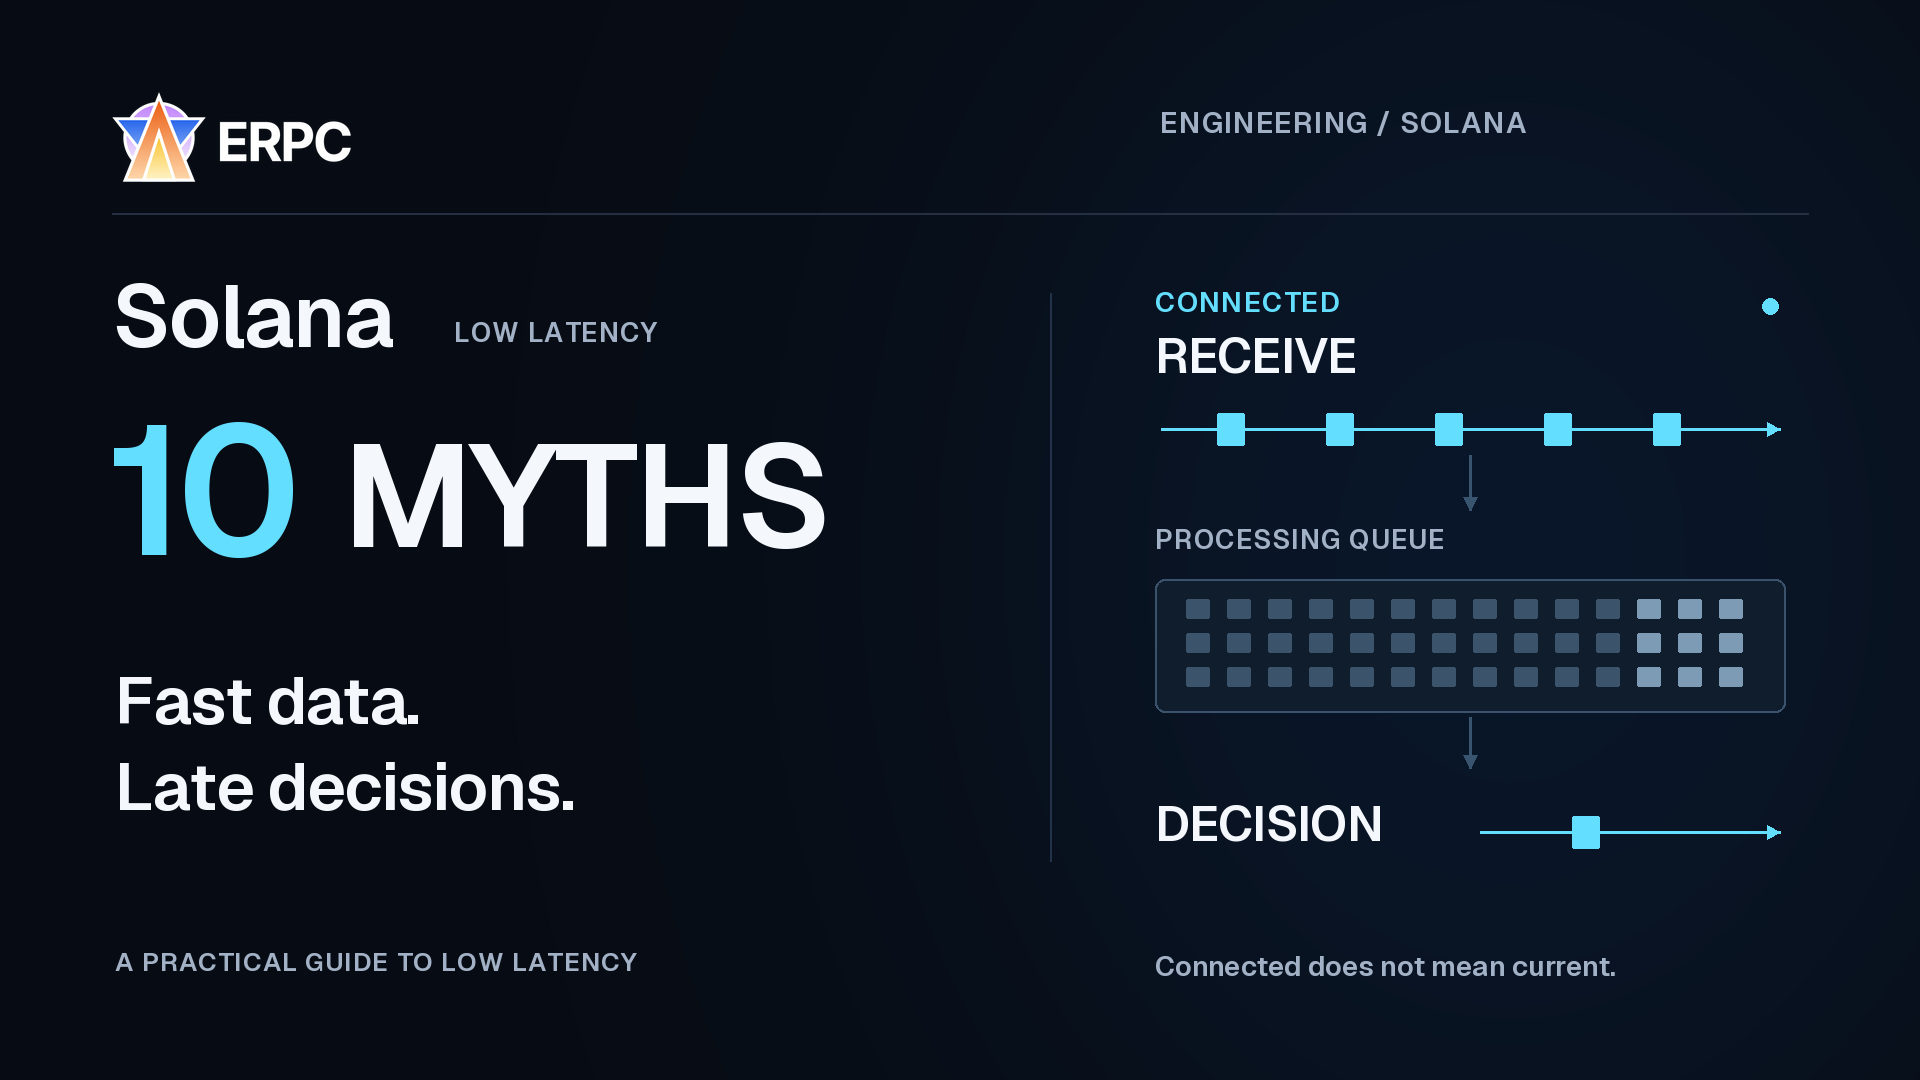
Die Verbindung ist schnell. Die CPU ist modern. Der Server steht in derselben Stadt wie der Datenanbieter. Trotzdem reagiert die Anwendung nur langsam auf die benötigten Informationen. Die Verbindung bleibt bestehen, doch die verarbeiteten Daten geraten immer weiter in Rückstand.
Beim Entwickeln latenzarmer Anwendungen auf Solana hat diese Situation nicht immer eine einzelne Ursache. Netzwerkrouten, Empfangseinstellungen, abonnierte Daten und Wartezeiten innerhalb der Anwendung können zusammen verhindern, dass die gewählte schnelle Infrastruktur vollständig genutzt wird.
Beim von ELSOUL LABO B.V. betriebenen ERPC begegnen unserem Support regelmäßig Fragen zu stockenden Empfangsschleifen, Clienteinstellungen, unnötig breiten Subscriptions und erneuten Verbindungsversuchen, die den ursprünglichen Fehler nicht beheben. Entscheidungen, die in einer herkömmlichen Webanwendung kaum Schwierigkeiten verursachten, können beim Hochfrequenzhandel und bei der Echtzeitverarbeitung zu Einschränkungen werden.
Dieser Artikel untersucht zehn Mythen hinter diesen Problemen. Er soll helfen, sowohl die Auswahl der Infrastruktur als auch das Design zu prüfen, das ihre Leistung bis zur Entscheidung und zum Versand einer Transaktion nutzbar macht.
Zuerst festlegen, was früher abgeschlossen sein soll
Die Netzwerklaufzeit hin und zurück, die Ankunftszeit von Daten, die Entscheidungsdauer und die Zeit bis zur Transaktionsbestätigung sind unterschiedliche Messgrößen. Ein schneller Ping verhindert keine langsamen Entscheidungen, wenn die Verarbeitung nach dem Empfang stockt. Eine schnelle RPC-Antwort bedeutet nicht unbedingt, dass die Transaktion ausgeführt wurde.
Definieren Sie zunächst Ihr Ziel, etwa die Zeit von der Beobachtung eines relevanten Ereignisses bis zum Abschluss der nötigen Entscheidung und zum Versand einer Transaktion. Messen Sie anschließend Beobachtung, Verarbeitung nach dem Empfang sowie Versand und Bestätigung getrennt. Verbesserungen beginnen damit, Geschwindigkeit genauer zu beschreiben als durch einen Produktnamen oder eine einzelne Zahl.
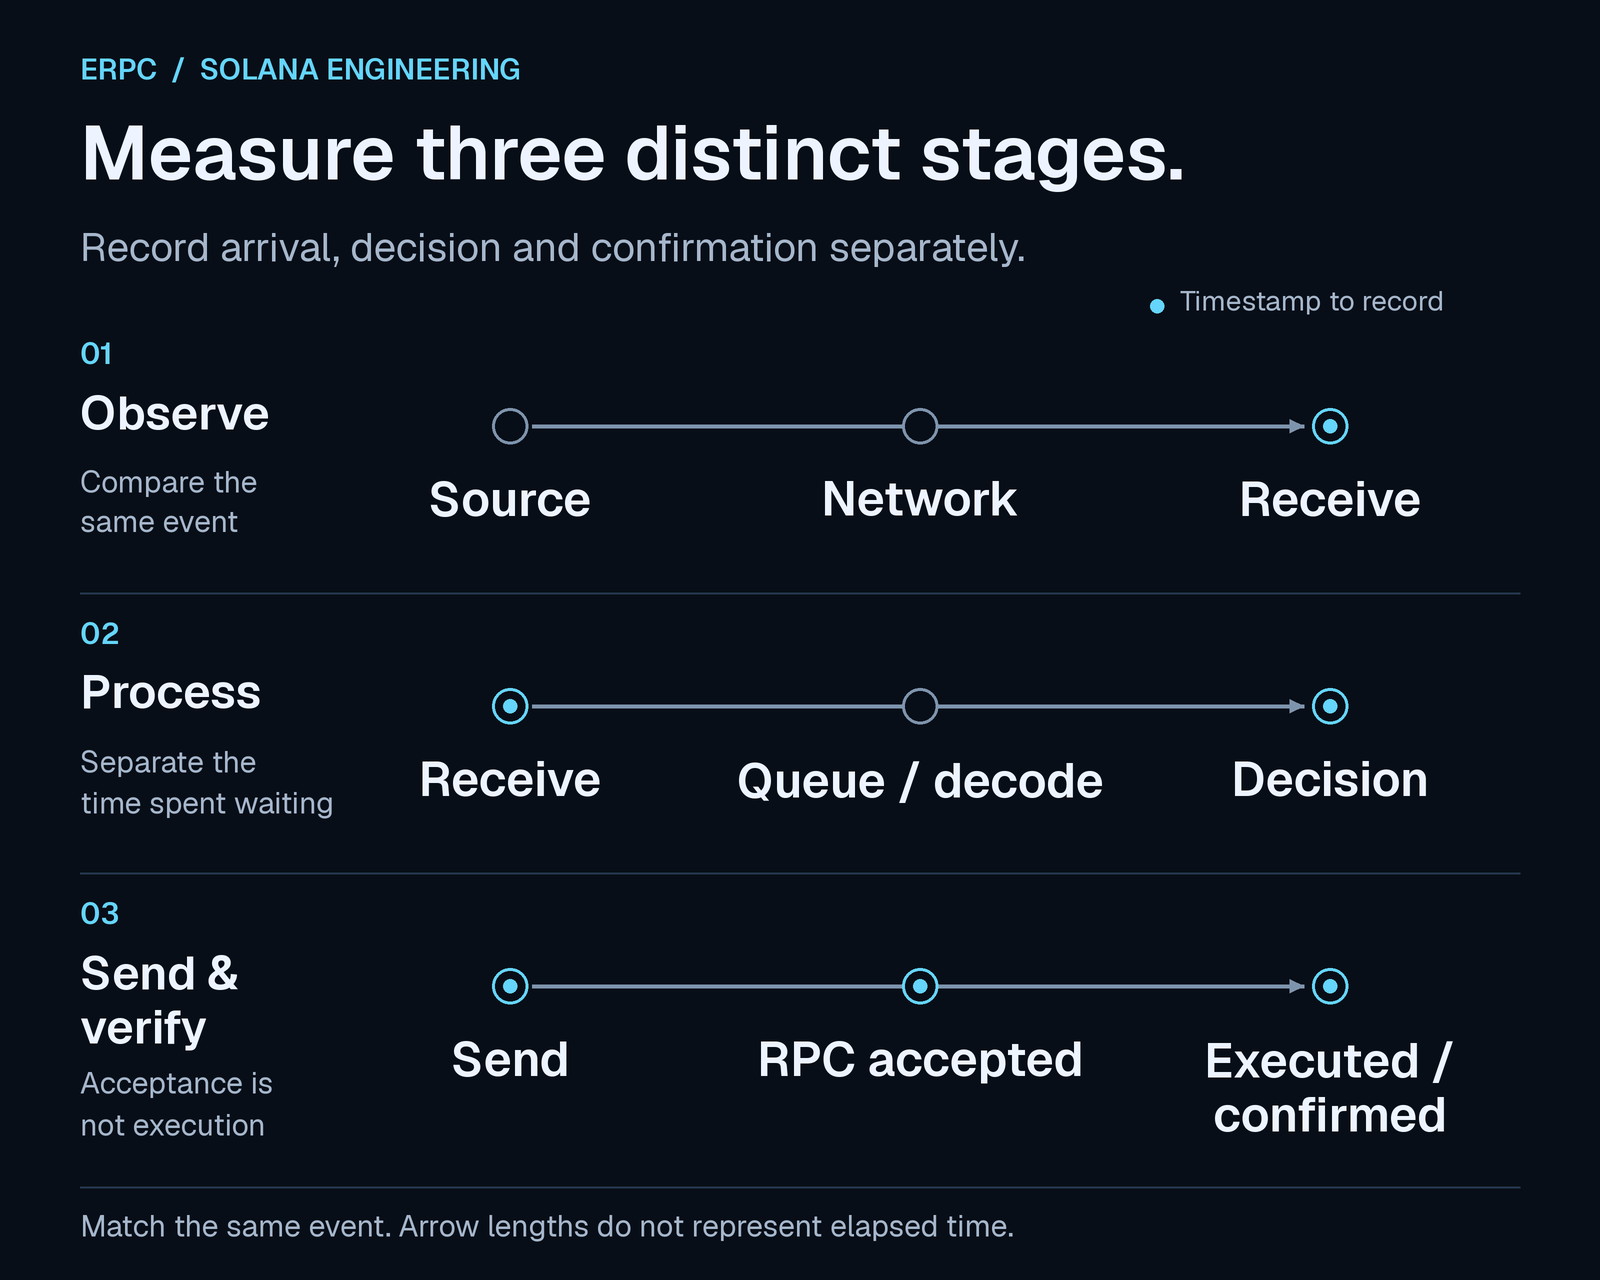
Das Diagramm veranschaulicht Messabschnitte. Es zeigt keine gemessenen Zeitdauern oder Leistungsunterschiede zwischen ihnen.
Mythos 1: Eine kleine VM läuft, also muss ihre Kapazität ausreichen
Eine kleine Cloud-VM funktionierte für eine frühere Webanwendung oder einen Ethereum-Workload gut. Daraus kann die Annahme entstehen, dieselbe Konfiguration werde auch einen Solana-Stream bewältigen. Eine Anwendung mit gelegentlichen RPC-Abfragen benötigt jedoch andere Ressourcen als eine Anwendung, die ständig einen breiten Umfang an Aktualisierungen empfängt und verarbeitet.
Dimensionieren Sie die Umgebung anhand von Datenmenge, Ankunftsrate, Aufwand pro Ereignis und zulässiger Latenz. Wie viele Ereignisse treffen pro Sekunde ein? Wie viele Bytes werden übertragen? Wie viel CPU-Zeit und Speicher verbrauchen Dekodierung und Entscheidungen? Planen Sie Reserven ein, um Spitzen ebenso wie den Normalbetrieb zu bewältigen. Selbst auf derselben Chain verändern Subscription-Umfang und Implementierung die Anforderungen.
Schwierig ist, dass eine Anwendung mit zu wenigen Ressourcen trotzdem funktionsfähig wirken kann. Auf dem Bildschirm erscheinen weiterhin Daten, die aber zunehmend veraltet sind. Oder Lücken beim erneuten Verbinden bleiben unentdeckt. Die Anzahl empfangener Ereignisse allein macht das nicht sichtbar. Prüfen Sie auch abgeschlossene Ereignisse, das Alter unverarbeiteter Daten und die Vollständigkeit der Ereignisfolge, die Ihre Subscription abdecken soll.
Wenn frühere Erfahrungen der einzige Bezugspunkt sind, hinterfragen Entwickler die Empfangskapazität möglicherweise nie und halten weiter den Datenendpunkt für die Ursache. Ein Versuch mit mehr Reserven kann Rückstände oder fehlende Daten offenlegen, die zuvor nicht erkennbar waren.
Vergleichen Sie zur Untersuchung denselben Endpunkt, dieselbe Subscription, dasselbe Commitment, dieselbe SDK samt Einstellungen und dieselbe Verarbeitung in einer Empfangs- und Verarbeitungsumgebung mit mehr Reserven. Halten Sie die Region gleich, dokumentieren Sie Unterschiede bei CPU, Speicher und Netzwerk und vergleichen Sie Empfangsdurchsatz, abgeschlossene Arbeit, Rückstand, fehlende Ereignisse und die Zeit bis zur Entscheidung. Die Last verändert sich im Zeitverlauf. Vergleichen Sie daher möglichst im selben Zeitraum und beachten Sie Verbindungslimits und die Belastung des Dienstes.
Eine Verbesserung nach dem Wechsel der Umgebung zeigt, dass Empfangs- oder Verarbeitungsbedingungen das Ergebnis beeinflusst haben. Wurden CPU, Speicher und Netzwerk gleichzeitig verändert, sind weitere Prüfungen nötig, um die entscheidende Ressource zu bestimmen. Die Ressourcen nach tatsächlicher Datenmenge und Datenrate auszuwählen, ist eine Voraussetzung für latenzarme Verarbeitung.
Mythos 2: Dieselbe Stadt bedeutet auch Nähe im Netzwerk
„Beide Server stehen in Frankfurt, also müssen sie nah beieinander sein.“ „Eine Bereitstellung in Tokyo muss für Japan am schnellsten sein.“ Städtenamen helfen bei der Standortwahl, garantieren aber nicht den tatsächlichen Weg des Datenverkehrs.
Dieser Weg hängt von Verbindungen zwischen Rechenzentren, Verbindungen zwischen Netzbetreibern und Routingentscheidungen ab. Selbst Server in derselben Stadt können einen Umweg über externe Netze nehmen. RIPE IPmap nennt beispielsweise die Visualisierung ineffizienter Routen, bei denen Verkehr ein Land verlässt und später zurückkehrt, als Anwendungsfall. [1]
Messen Sie die RTT zwischen der tatsächlichen Datenquelle und dem Host Ihrer Anwendung, Schwankungen über die Zeit, erneute Übertragungen oder Verluste sowie die Ankunftszeit desselben Ereignisses. Traceroute und MTR helfen bei der Untersuchung des Pfads, doch die Anzahl der Hops allein entscheidet nicht über seine Qualität. Eine Begrenzung diagnostischer Antworten durch einen Zwischenrouter darf außerdem nicht mit Paketverlust verwechselt werden, der die Anwendung betrifft.
Stellen Sie nach der Regionswahl eine weitere Frage: Wie sind genau diese Datenquelle und genau dieser Server tatsächlich verbunden? Diese zusätzliche Prüfung macht Unterschiede sichtbar, die ein Städtename allein nicht zeigt.
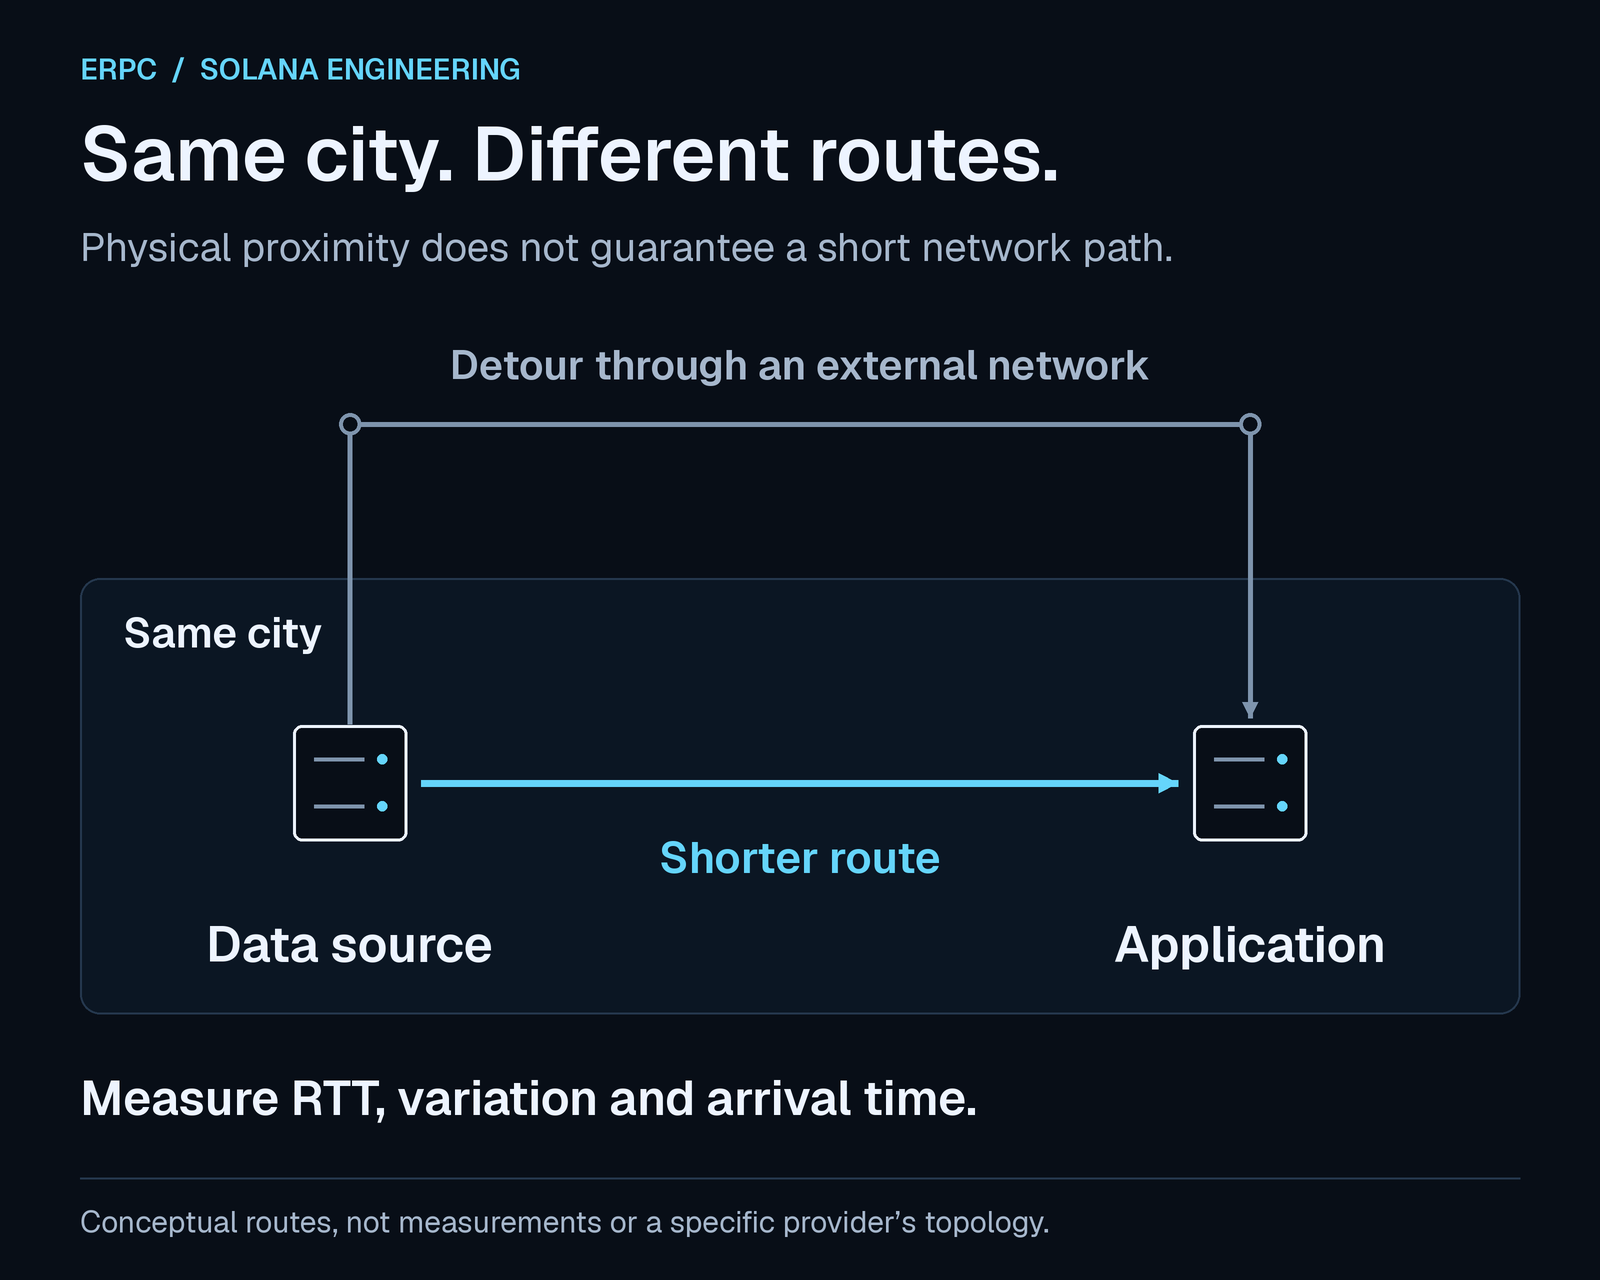
Das Diagramm erläutert einen Routingunterschied. Es bildet nicht das tatsächliche Netzwerk eines bestimmten Anbieters ab.
Mythos 3: Eine hohe Netzwerkspezifikation bedeutet ausreichend nutzbare Bandbreite
Bandbreite in einer Serverspezifikation kann unterschiedliche Bedeutungen haben: physische Portgeschwindigkeit, einer virtuellen Maschine zugewiesene Bandbreite, dauerhaft verfügbare Bandbreite oder eine kurzfristige Burst-Grenze. Eine schnelle NIC bedeutet nicht, dass die Anwendung ihre gesamte Kapazität dauerhaft nutzen kann.
Die AWS-Dokumentation unterscheidet beispielsweise zwischen Basis- und Burst-Bandbreite und beschreibt Einschränkungen durch Verkehrsziele, Flows und Paketraten. Das zeigt, wie eine Spezifikation zu lesen ist. Es bedeutet nicht, dass jeder VPS denselben Grenzen wie AWS unterliegt. [2]
Prüfen Sie bei der Tarifwahl, ob die Bandbreite exklusiv oder geteilt ist, welche Bedingungen für dauerhafte Nutzung gelten, welche Übertragungskontingente bestehen und ob Ziele unterschiedlich behandelt werden. Halten Sie beim Testen den Verkehr zum selben Endpunkt unter denselben Subscription-Bedingungen wie im geplanten Produktivbetrieb aufrecht. Beobachten Sie dabei gleichzeitig Empfangsdurchsatz, Drops, erneute Übertragungen und CPU-Last.
Ein hoher Wert in einem kurzen Geschwindigkeitstest beweist nicht, dass ein Server einen Produktionsstream dauerhaft verarbeiten kann. Gleichzeitig bedeutet geringer Empfangsdurchsatz nicht zwangsläufig fehlende Bandbreite. Trennen Sie Probleme der Empfangseinstellungen von Verarbeitungsgrenzen, bevor Sie die Verbindung aufrüsten.
Mythos 4: Ein besseres CPU-Modell, mehr Kerne oder höhere maximale GHz machen die Anwendung schnell
Die maximale Boost-Frequenz einer CPU ist keine Taktfrequenz, die sie bei jedem Workload hält. Ihr tatsächlicher Betrieb hängt von Leistung, Temperatur, Firmware, Frequenzsteuerung und anderen Workloads ab. Laut Linux-Dokumentation erlaubt das Aktivieren von Boost dessen Nutzung; es beweist nicht, dass die CPU tatsächlich im Boost arbeitet. [3]
Konzentriert sich wichtige Arbeit auf einen Thread, wird diese Arbeit durch zusätzliche Kerne allein nicht früher fertig. Die gesamte CPU-Auslastung kann niedrig aussehen, während ein einzelner Kern oder Event Loop ausgelastet ist. Auch die offizielle Node.js-Anleitung erläutert, wie ein aufwendiger Callback andere Arbeit warten lässt. [4]
Prüfen Sie Taktfrequenz, Temperatur, Auslastung pro Kern und Verarbeitungszeiten unter Ihrer tatsächlichen Last. In einer virtuellen Umgebung kann auch die Wartezeit auf CPU-Zuteilung aufschlussreich sein. Erstellen Sie ein Profil der Anwendung, um den Zeitbedarf für Dekodierung, Berechnung, Speicherallokation und Logging zu ermitteln.
Wählen Sie eine Kombination aus CPU-Taktleistung, Ressourcenzuweisung, Einstellungen für anhaltende Leistung und Anwendungsimplementierung. Modellnummern allein bestimmen nicht, wie schnell die gesamte Anwendung arbeitet.
Mythos 5: Bei gRPC reichen die Standardeinstellungen des Clients
Eine aufgebaute gRPC-Verbindung beweist nicht, dass sie das benötigte Datenvolumen mit der erforderlichen Geschwindigkeit empfangen kann. HTTP/2 besitzt eine Flusskontrolle, mit der der Empfänger dem Sender mitteilt, wie viele Daten er annehmen kann. Diese greift sowohl pro Stream als auch pro Verbindung. Empfangsfenster und deren Aktualisierung können deshalb den Durchsatz begrenzen, selbst wenn die Netzwerkverbindung noch Kapazität hat. [5][6]
Ein Empfangsfenster teilt dem Sender mit, wie viele Daten er ohne weitere Aktualisierung durch den Empfänger senden darf. Anfangswerte, automatische Anpassung und Vorrang von Einstellungen unterscheiden sich zwischen SDKs und Bibliotheken. Eine große Zahl in einer Konfigurationsdatei beweist nicht, dass der Client wie beabsichtigt arbeitet. Prüfen Sie Stream- und Verbindungseinstellungen, ihre Wechselwirkung mit adaptiven Einstellungen und die verwendete Version.
Nehmen Sie Änderungen vor, während Sie tatsächlichen Empfangsdurchsatz und Verarbeitungsrückstand unter gleichen Subscription-Bedingungen messen. Die maximale Größe einer empfangbaren Nachricht, der TCP-Empfangspuffer und das HTTP/2-Empfangsfenster sind getrennte Einstellungen. Keepalive prüft, ob die Verbindung noch besteht; es erhöht weder Verarbeitungskapazität noch Bandbreite.
Die gRPC-FAQ von ERPC enthält Schritte zur Fehlersuche und Beispiele für Clientkonfigurationen bei Streams, deren Durchsatz konstant bleibt, während der Rückstand wächst. Nutzen Sie die Beispiele als Ausgangspunkt und prüfen Sie sie anschließend mit Ihrem Subscription-Volumen und Ihrer Verarbeitungskapazität. [7]
Mythos 6: Wer jeden vollständigen Block empfängt, entscheidet am frühesten
„Zuerst alles empfangen, anschließend das Wichtige suchen.“ Das ist ein nachvollziehbarer Einstieg in die Entwicklung, fügt aber Arbeit hinzu, die vor einer Entscheidung möglicherweise nicht nötig ist. Übertragen, Dekodieren, Speicherallokation und Durchsuchen unnötiger Daten verbrauchen endliche Bandbreite und CPU-Ressourcen.
Wenn Sie auf Änderungen in einem bestimmten Markt, Programm oder Account reagieren möchten, definieren Sie zuerst die dafür erforderlichen Ereignisse und Felder. Yellowstone gRPC bietet Subscription-Filter für Transaktionen und Accounts sowie die Möglichkeit, nur einen Teil der Accountdaten abzurufen. Meldungen über vollständige Blöcke unterscheiden sich außerdem von Meldungen über einzelne Aktualisierungen. [8]
Wartet bei gleichen Ressourcen und Bedingungen eine Anwendung auf das Dekodieren und Durchsuchen aller Datensätze, während eine andere die erforderliche Aktualisierung sofort verarbeiten kann, vermeidet die zweite diese Wartezeit. Ein stärker fokussierter Wettbewerber kann aus Gründen jenseits der Netzwerkverbindung wiederholt früher reagieren. Zu entscheiden, was ignoriert werden darf, gehört zum latenzarmen Design.
Indexierung, Audits, Forschung und historische Speicherung können berechtigterweise alle Daten benötigen. Stellen Sie dafür einen eigenen Verarbeitungspfad bereit. Durch die Trennung von unmittelbaren Entscheidungen lassen sich Kapazität und Vollständigkeit für jeden Pfad passend gestalten. Prüfen Sie jedoch, dass die Filterung keine für korrekte Entscheidungen erforderlichen Updates entfernt. Batchverarbeitung kann in manchen Fällen den Gesamtdurchsatz erhöhen. Wählen Sie sie daher nach der Wartezeit, die Ihre Anwendung toleriert.
Beim aktuellen Shared-gRPC-Dienst von ERPC erfordert eine nicht leere
blocks-Subscription einen Dedicated-Dienst. transactions-Subscriptions oder blocksMeta können einen bestimmten Bedarf abdecken, liefern aber nicht dieselben Daten wie vollständige Blöcke. Auch bei Dedicated bleiben passende Verarbeitungskapazität auf Empfängerseite und ein geeignetes Subscription-Design nötig. [9]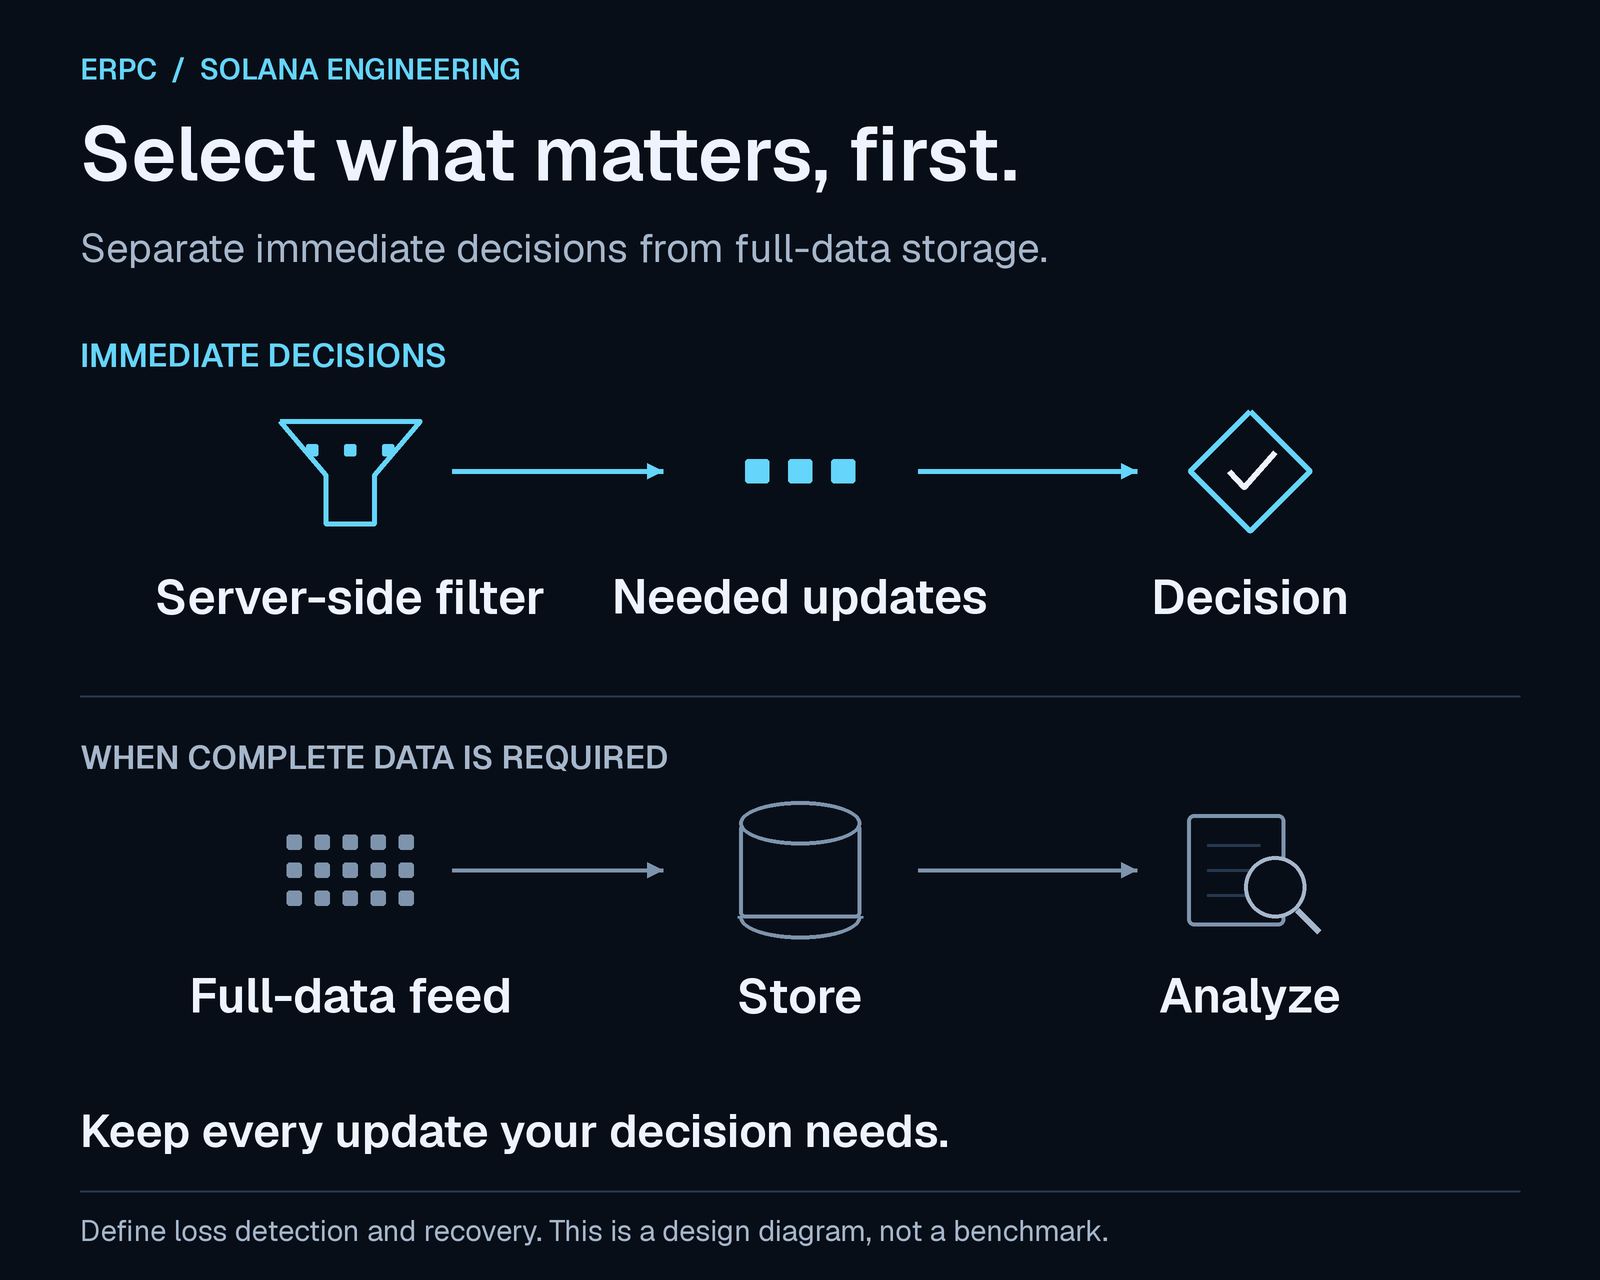
Das Diagramm zeigt einen Architekturansatz. Definieren Sie beim Eingrenzen von Subscriptions sowohl die nötigen Entscheidungsinformationen als auch die Wiederherstellung bei fehlenden Daten.
Mythos 7: Wenn Daten ankommen, hält die Verarbeitung Schritt
Zwischen dem Empfang und der Verarbeitung in einen für Entscheidungen nutzbaren Zustand kann sich eine Warteschlange bilden. Übersteigt die eingehende Arbeit dauerhaft die Verarbeitungskapazität, wächst der Rückstand auch bei offener Verbindung. Ein größerer Puffer kann kurzfristige Spitzen aufnehmen. Bei einem anhaltenden Verarbeitungsdefizit hält er jedoch lediglich mehr alte Daten vor.
Messen Sie nicht nur die Anzahl empfangener Ereignisse. Erfassen Sie auch abgeschlossene Verarbeitung, Warteschlangenlänge, das Alter des ältesten unverarbeiteten Eintrags und die Zeit vom Empfang bis zum Entscheidungsabschluss. Überwachen Sie Verbindungszustand und Datenaktualität getrennt.
Belassen Sie in der Empfangsschleife nur die Arbeit, die zur Aufrechterhaltung des Empfangs nötig ist. Prüfen Sie, ob Datenbankschreibvorgänge, vollständiges Payload-Logging, externe API-Aufrufe und aufwendige Berechnungen auf andere Verarbeitungspfade verlagert werden können. Geben Sie Warteschlangen eine Kapazitätsgrenze und eine Strategie für den Fall, dass sie voll sind. Eine begrenzte Warteschlange kann vorgelagerte Arbeit ebenfalls blockieren, sobald sie sich füllt; sie behebt unzureichende Verarbeitungskapazität nicht von selbst. [10]
Bei Aktualisierungen, für die nur der neueste Zustand zählt, lassen sich ältere Zustände unter Umständen zusammenfassen. Transaktionsereignisse, die vollständig oder in Reihenfolge verarbeitet werden müssen, dürfen nicht wahllos verworfen werden. Gestalten Sie Lückenerkennung, erneuten Abruf und Zustandswiederherstellung nach einer Neuverbindung entsprechend den Anforderungen der Anwendung.
ERPCs
STREAM_GUARD_SLOW_READER ist eine Schutzreaktion auf unzureichenden Schreibfortschritt oder beobachtete Lieferverzögerung. Leiten Sie daraus allein keine Ursache ab. Untersuchen Sie Verbindung, Host, Subscription-Volumen und Verarbeitungstempo der Anwendung. Bewahren Sie vor dem erneuten Verbinden den ersten Status, die Nachricht, Metadaten und Trailer auf, soweit verfügbar. Lesen Sie dann den Grund und die Wiederholungsbedingungen des Servers. Dieselbe abgelehnte Anfrage ohne Korrektur erneut zu senden, lässt die Ursache bestehen. [7]Mythos 8: Ein schneller Ping oder Durchschnitt bedeutet Schnelligkeit im entscheidenden Moment
Ping liefert einen Hinweis auf die Netzwerklaufzeit hin und zurück. Er misst einen anderen Abschnitt als die Anwendungslatenz, die Verarbeitung an der Quelle, Subscription-Inhalt, Warten auf Empfang, Dekodierung und Entscheidung umfasst. Ein Durchschnitt kann außerdem wenige, aber erhebliche Verzögerungen verdecken.
p50 ist der Median. p95 und p99 bezeichnen die Werte, unter denen beziehungsweise auf denen 95% und 99% der Messwerte liegen. p99 ist nicht das Maximum. Geben Sie Stichprobengröße und Messzeitraum an und prüfen Sie Werte bei Ereignisspitzen, Maxima, Timeouts, Verbindungsabbrüche und fehlende Daten. [11]
Vergleichen Sie bei unterschiedlichen Anbietern dasselbe Ereignis, denselben Datentyp, dasselbe Commitment und dieselben Subscription-Bedingungen. Empfangen Sie nach Möglichkeit auf demselben Messhost und verwenden Sie für verstrichene Zeit innerhalb der Anwendung eine monotone Uhr. Beim Subtrahieren von Zeitstempeln verschiedener Hosts müssen Uhrabweichungen berücksichtigt werden, die die Messung verfälschen können.
Wer nur erfolgreiche Ereignisse behält, kann eine Konfiguration mit häufig fehlenden Daten schnell aussehen lassen. Das schnellste Einzelergebnis zu wählen ist eine andere Entscheidung, als eine Konfiguration auszuwählen, die im benötigten Produktionsmoment seltener zurückfällt.
Mythos 9: Die frühesten Daten sind ebenso endgültig und bedeuten dasselbe
Shreds, Transaktionsmeldungen, Account-Updates und Blockmeldungen stellen nicht dieselben Informationen in derselben Phase dar. Daten aus einer früheren Phase können mehr Rekonstruktion oder Interpretation durch die Anwendung erfordern. Ein Vergleich muss deshalb nicht nur Empfangszeiten, sondern auch den zu diesem Zeitpunkt möglichen Wissensstand aufeinander abstimmen. [8][12]
Unterscheiden Sie außerdem Solanas Commitment-Stufen
processed, confirmed und finalized. Werden frühe Beobachtungen für Entscheidungen verwendet, muss die Anwendung später den Bestätigungszustand prüfen und ihren Zustand bei Bedarf korrigieren. Trennen Sie den Empfang einer frühen Aktualisierung von den Voraussetzungen für eine endgültige Aktion in einem externen System. [13]Meldungen unterschiedlicher Commitments einfach nebeneinanderzustellen und eine davon als eine bestimmte Anzahl Millisekunden schneller zu bezeichnen, vergleicht beispielsweise nicht dieselbe Arbeit. Bestimmen Sie die benötigten Informationen und die erforderliche Finalität und messen Sie, wann unter diesen Bedingungen eine Entscheidung möglich wird.
Mythos 10: Ein erfolgreicher Versand bedeutet, dass die Transaktion zuerst ausgeführt wird
Eine erfolgreiche
sendTransaction-Antwort bedeutet, dass die RPC die Transaktion angenommen hat. Sie garantiert weder Verarbeitung noch Bestätigung durch den Cluster. Die Solana-Spezifikation verlangt ausdrücklich, den Signaturstatus gesondert zu prüfen. [14]Selbst wenn eingehende Informationen eine frühe Entscheidung erlauben, bleiben Versandpfad, Blockhash-Gültigkeit, Konkurrenz um beschreibbare Accounts, Rechenressourcen, Prioritätsgebühren und die eigenen Erfolgsbedingungen der Transaktion relevant. SWQoS betrifft Zulassung und Verbindungspriorität zum Leader, während Prioritätsgebühren die Scheduling-Priorität beeinflussen. Die Rollen unterscheiden sich. Keines von beiden garantiert bedingungslos Ausführungsreihenfolge oder Erfolg. [15][16]
Erfassen Sie Entscheidungsabschluss, Versandbeginn, RPC-Annahme, Ausführungsergebnisse und den erforderlichen Bestätigungszustand getrennt. Unterscheiden Sie bei Wiederholungen außerdem zwischen erneutem Versand einer Transaktion mit derselben Signatur und dem Erstellen einer neuen Transaktion, damit unbeabsichtigte doppelte Aktionen vermieden werden.
Erst wenn der gesamte Weg vom Empfang bis zur Bestätigung beobachtbar ist, lässt sich feststellen, welche Verbesserung näher an das Ziel führt.
Welche Messungen zuerst eingerichtet werden sollten
Sie müssen nicht alle Optimierungen gleichzeitig anwenden. Erfassen Sie zunächst die folgenden Größen unter vergleichbaren Bedingungen, um die Wirkung einer Änderung beurteilen zu können.
| Abschnitt | Was erfasst wird | Welche Probleme sichtbar werden |
|---|---|---|
| Netzwerk und Empfang | Tatsächlicher Empfangsdurchsatz, erneute Übertragungen und Verluste, Ankunftsunterschiede desselben Ereignisses | Grenzen durch Routing, Bandbreite und Empfangseinstellungen |
| Anwendung | Empfangene und abgeschlossene Ereignisse, Warteschlangenlänge, Alter des ältesten Eintrags | Anhaltende Verarbeitungsdefizite und angesammelte veraltete Daten |
| Zeit bis zur Entscheidung | p50, p95, p99 und maximale Zeit vom Empfang bis zum Entscheidungsabschluss | Aufwendige Verarbeitung und Verzögerungen bei Spitzen |
| Versand und Bestätigung | Versandbeginn, RPC-Annahme, Signaturstatus, Ausführungsfehler | Verzögerungen und Fehler nach dem Empfang |
| Vergleichsbedingungen | Region, Host, SDK und Version, Subscription, Commitment, Zeitraum und Stichprobengröße | Scheinbare Unterschiede durch abweichende Bedingungen |
Bewahren Sie eine Ausgangsmessung auf und prüfen Sie anschließend symptomabhängig jeweils eine Änderung: Subscription-Umfang, Verarbeitungstrennung, Clienteinstellungen sowie Platzierung oder Ressourcen. Kontrollieren Sie beim Vergrößern eines Fensters auch Speicherverbrauch und Rückstand. Prüfen Sie beim Eingrenzen einer Subscription, ob benötigte Informationen verloren gehen.
Die p99 der Gesamtzeit ergibt sich nicht durch einfaches Addieren der p99 aller Abschnitte. Berechnen Sie sie aus der Gesamtzeit jedes zugeordneten Ereignisses und nutzen Sie Abschnittsmessungen zur Ursachenbestimmung. Testen Sie sowohl während tatsächlicher Ereignisspitzen als auch bei durchschnittlicher Last.
ERPC bereitet die Infrastruktur vor, damit Entwickler ihre Logik verfeinern können
Werden Netzwerke, Server, Datenbereitstellung und Clients getrennt ausgewählt, können zwischen ihnen Wartezeiten verbleiben, selbst wenn jede Komponente gute Spezifikationen hat. ERPC vereint Solana-Datenbereitstellung und Verarbeitungsumgebungen auf einer Plattform und verringert die Arbeit, die Entwickler sonst bei der Standort- und Ressourcenwahl immer wieder von vorn beginnen.
SUPER VPS und Premium VPS bieten laut Spezifikation hohe Taktfrequenzen und Ressourcenzuweisung ohne Overcommitment. Bare Metal stellt eine physisch exklusiv genutzte Maschine bereit. ERPC bringt Netzwerke und Server nahe an seine Datenbereitstellungsumgebung und richtet CPU, Speicher, Storage und Verbindungen auf dauerhafte Verarbeitung aus. Konkrete Spezifikationen sind für jeden Tarif und jede Region verfügbar. [17][18]
| Häufiges Entwicklungsproblem | Infrastruktur und Informationen von ERPC | Was in der Anwendung verfeinert wird |
|---|---|---|
| Entfernung, die Städtenamen nicht zeigen | Regions- und Netzwerkkonfigurationen zur gemeinsamen Wahl von Datenbereitstellung und Verarbeitung | Ankunftszeiten und Schwankungen unter den eigenen Subscription-Bedingungen messen |
| Ressourcenkonkurrenz und anhaltende Leistung | Hoch getaktete SUPER VPS und Premium VPS ohne Overcommitment sowie exklusives Bare Metal | Aufwendige und serielle Verarbeitung erkennen |
| Datenvolumen und Verbindungsmethode | gRPC, Shreds, RPC sowie geteilte oder dedizierte Optionen passend zum Workload | Erforderliche Ereignisse und Felder definieren |
| Empfangseinstellungen und Fehlersuche | Solana Stream SDK, Konfigurationsbeispiele, Filterdokumentation und fehlerspezifische FAQs | Effektive Einstellungen, Warteschlangen, Neuverbindung und Wiederherstellung prüfen |
ERPC hilft Entwicklern bei Auswahl und Abstimmung der Infrastruktur. So bleibt mehr Zeit dafür, festzulegen, was beobachtet wird, welche Informationen Entscheidungen tragen und wann gesendet wird. Mit geeignetem Dienst und Standort macht die Abstimmung von Subscription-Volumen und Verarbeitungskapazität Infrastrukturleistung zu Anwendungsgeschwindigkeit.
Beginnen Sie mit der Frage, welche Informationen Ihre Entscheidungen wirklich benötigen. Empfangen Sie diese früh, verarbeiten Sie sie ohne unnötiges Warten und prüfen Sie das Ergebnis. ERPC wird weiterhin die Umgebung und Informationen bereitstellen, die diese Verbesserung unterstützen.
Ressourcen für die Implementierung
- ERPC gRPC-FAQ: https://erpc.global/de/faq/grpc/general/
- Subscription-Filter und aktuelle Shared-Grenzen: https://erpc.global/de/doc/geyser-grpc/filter/
- Best Practices für gRPC-Implementierungen: https://erpc.global/de/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/de/vps/
- ERPC Bare Metal: https://erpc.global/de/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Offizieller Discord von Validators DAO: https://discord.gg/C7ZQSrCkYR
Technische Quellen
- RIPE IPmap, Visualisierung ineffizienter Routen: https://ipmap.ripe.net/
- AWS, Netzwerkbandbreite von Instances: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, Blockieren des Event Loops vermeiden: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, HTTP/2-Flusskontrolle: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, Empfangseinstellungen, Slow Reader und Wiederholungen in der gRPC-FAQ: https://erpc.global/de/faq/grpc/general/
- Yellowstone gRPC, Spezifikationen für Subscriptions und Filter: https://github.com/rpcpool/yellowstone-grpc
- ERPC, aktuelle Shared-Filterregeln: https://erpc.global/de/doc/geyser-grpc/filter/
- Tokio, Warteschlangen und Backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, Definition von Perzentilen: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/de/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, Transaktionsgebühren: https://solana.com/docs/core/fees
- ERPC, VPS-Konfigurationen und Spezifikationen: https://erpc.global/de/vps/
- ERPC, Bare-Metal-Konfigurationen und Spezifikationen: https://erpc.global/de/baremetal/