Tien mythes die Solana-applicaties vertragen: waarom een snelle omgeving toch traag kan zijn
Je verbinding is snel. Je CPU is modern. Je server staat in dezelfde stad als de dataleverancier. Toch reageert je applicatie traag op de informatie die zij nodig heeft. De verbinding blijft open, maar de gegevens die worden verwerkt, lopen steeds verder achter.
Bij het bouwen van applicaties met lage latency op Solana heeft deze situatie niet altijd één oorzaak. Netwerkroutes, ontvangstinstellingen, de gegevens waarop je je abonneert en wachttijd binnen de applicatie kunnen samen verhinderen dat je de gekozen snelle infrastructuur volledig benut.
Bij ERPC, beheerd door ELSOUL LABO B.V., krijgt ons supportteam regelmatig vragen over vastlopende ontvangstlussen, clientinstellingen, onnodig brede subscriptions en nieuwe verbindingspogingen die de oorspronkelijke fout niet oplossen. Keuzes die in een gewone webapplicatie weinig problemen opleverden, kunnen beperkingen worden bij hoogfrequente handel en realtimeverwerking.
Dit artikel behandelt tien mythes achter deze problemen. Het doel is om zowel je infrastructuurkeuze te kunnen beoordelen als het ontwerp dat die prestaties doorgeeft aan beslissingen en het verzenden van transacties.
Bepaal eerst wat eerder klaar moet zijn
De heen-en-terugtijd over het netwerk, de aankomsttijd van gegevens, de beslistijd en de tijd tot een transactie is bevestigd, zijn verschillende meetwaarden. Een snelle ping voorkomt geen trage beslissingen als de verwerking na ontvangst vastloopt. Een snel RPC-antwoord betekent niet noodzakelijk dat de transactie is uitgevoerd.
Definieer eerst je doel, bijvoorbeeld de tijd tussen het waarnemen van een relevant event en het afronden van de benodigde beslissing en het verzenden van een transactie. Meet vervolgens de waarneming, de verwerking na ontvangst en het verzenden en bevestigen afzonderlijk. Verbetering begint bij een definitie van snelheid die verder gaat dan één productnaam of één getal.
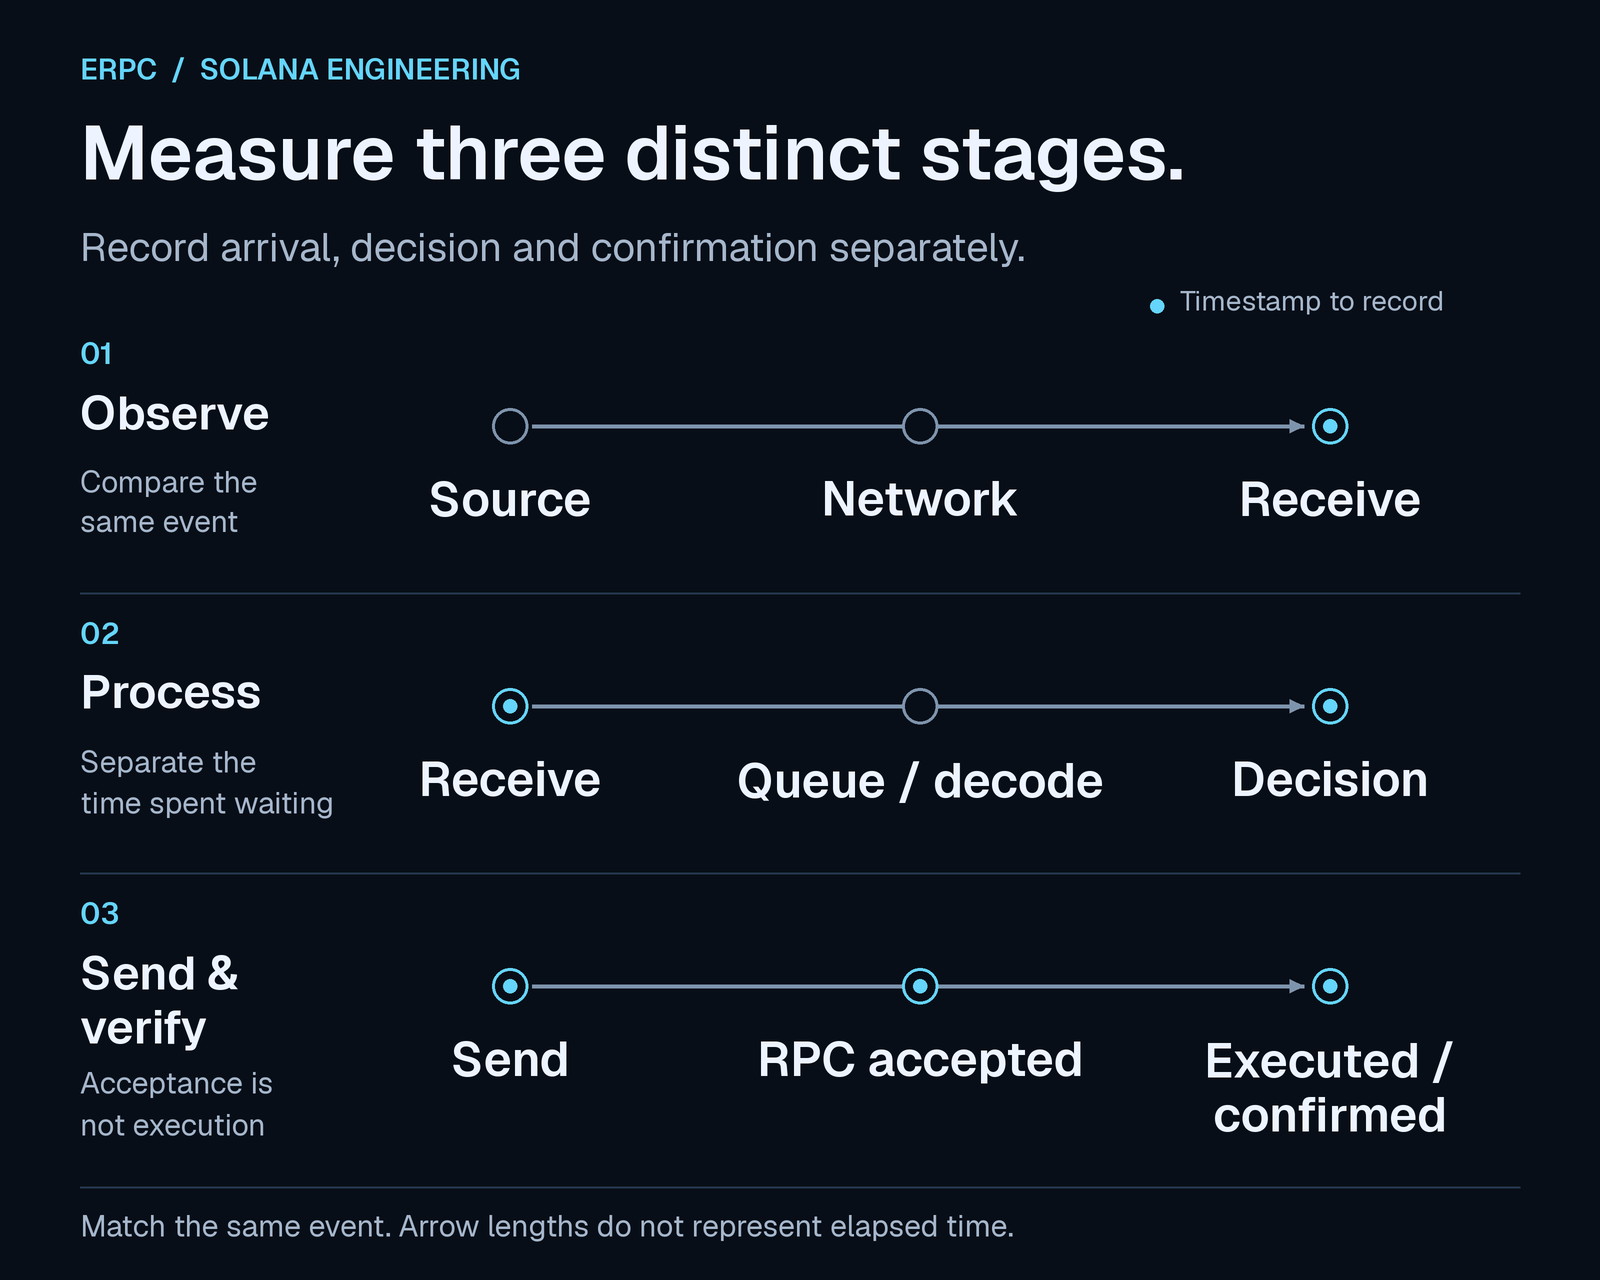
Dit diagram toont meetfasen. Het geeft geen gemeten tijdsduren of prestatieverschillen tussen de fasen weer.
Mythe 1: Een kleine VM draait, dus de capaciteit moet voldoende zijn
Een kleine cloud-VM werkte goed voor een eerdere webapplicatie of een Ethereum-workload. Die ervaring kan verleiden tot de aanname dat dezelfde configuratie ook een Solana-stream aankan. Maar een applicatie die af en toe RPC-verzoeken doet, vraagt andere resources dan een applicatie die voortdurend een breed scala aan updates ontvangt en verwerkt.
Dimensioneer de omgeving op basis van datavolume, aankomstsnelheid, werk per event en aanvaardbare latency. Hoeveel events komen er per seconde binnen? Hoeveel bytes worden overgedragen? Hoeveel CPU-tijd en geheugen kosten het decoderen en de beslissingen? Houd voldoende reserve om zowel pieken als normaal verkeer bij te houden. Zelfs op dezelfde chain veranderen de scope van subscriptions en de implementatie de vereisten.
Het lastige is dat een applicatie met te weinig resources toch kan lijken te werken. Er blijven gegevens op het scherm verschijnen terwijl ze steeds ouder worden, of ontbrekende events tijdens het opnieuw verbinden blijven onopgemerkt. Alleen het aantal ontvangen events laat dit niet zien. Controleer ook het aantal verwerkte events, de ouderdom van onverwerkte gegevens en de continuïteit van de events die je subscription moet omvatten.
Als eerdere ervaring het enige referentiepunt is, stellen ontwikkelaars de ontvangstcapaciteit mogelijk nooit ter discussie en blijven ze het data-endpoint als oorzaak zien. Een omgeving met meer reserve uitproberen kan achterstanden of ontbrekende gegevens zichtbaar maken die eerder onopgemerkt bleven.
Vergelijk voor het onderzoek hetzelfde endpoint, dezelfde subscription, commitment, SDK en instellingen en dezelfde verwerking in een ontvangst- en verwerkingsomgeving met meer reserve. Houd de regio gelijk, leg verschillen in CPU, geheugen en netwerk vast en vergelijk de ontvangen hoeveelheid, het afgeronde werk, de achterstand, ontbrekende events en de tijd tot een beslissing. De belasting varieert in de tijd. Vergelijk daarom waar mogelijk in dezelfde periode en houd rekening met verbindingslimieten en de belasting van de dienst.
Verbetering na een wijziging van de omgeving laat zien dat de ontvangst- of verwerkingsomstandigheden het resultaat beïnvloedden. Als CPU, geheugen en netwerk tegelijk veranderden, zijn verdere controles nodig om te bepalen welke resource van belang was. Resources kiezen op basis van de werkelijke hoeveelheid en snelheid van de gegevens is een voorwaarde voor verwerking met lage latency.
Mythe 2: Dezelfde stad betekent ook dichtbij op het netwerk
“Beide servers staan in Frankfurt, dus ze moeten dichtbij zijn.” “Een server in Tokyo moet het snelst zijn voor Japan.” Stadsnamen helpen bij het kiezen van locaties, maar garanderen niet de route die het verkeer werkelijk aflegt.
Die route hangt af van verbindingen tussen datacenters, verbindingen tussen netwerkbeheerders en routeringsbeslissingen. Zelfs servers in dezelfde stad kunnen via externe netwerken een omweg maken. RIPE IPmap noemt bijvoorbeeld het zichtbaar maken van inefficiënte routes, zoals verkeer dat een land verlaat en daarna terugkeert, als toepassing. [1]
Meet de RTT tussen de daadwerkelijke databron en de host waarop je applicatie draait, variatie in de tijd, hertransmissies of verlies en de aankomsttijd van hetzelfde event. Traceroute en MTR helpen bij het onderzoeken van de route, maar het aantal hops bepaalt niet op zichzelf welke route beter is. Verwar ook een tussenliggende router die zijn diagnostische antwoorden beperkt niet met pakketverlies dat de applicatie raakt.
Stel na het kiezen van een regio nog één vraag: hoe zijn deze specifieke databron en deze specifieke server werkelijk verbonden? Die extra controle toont verschillen die een stadsnaam alleen niet laat zien.
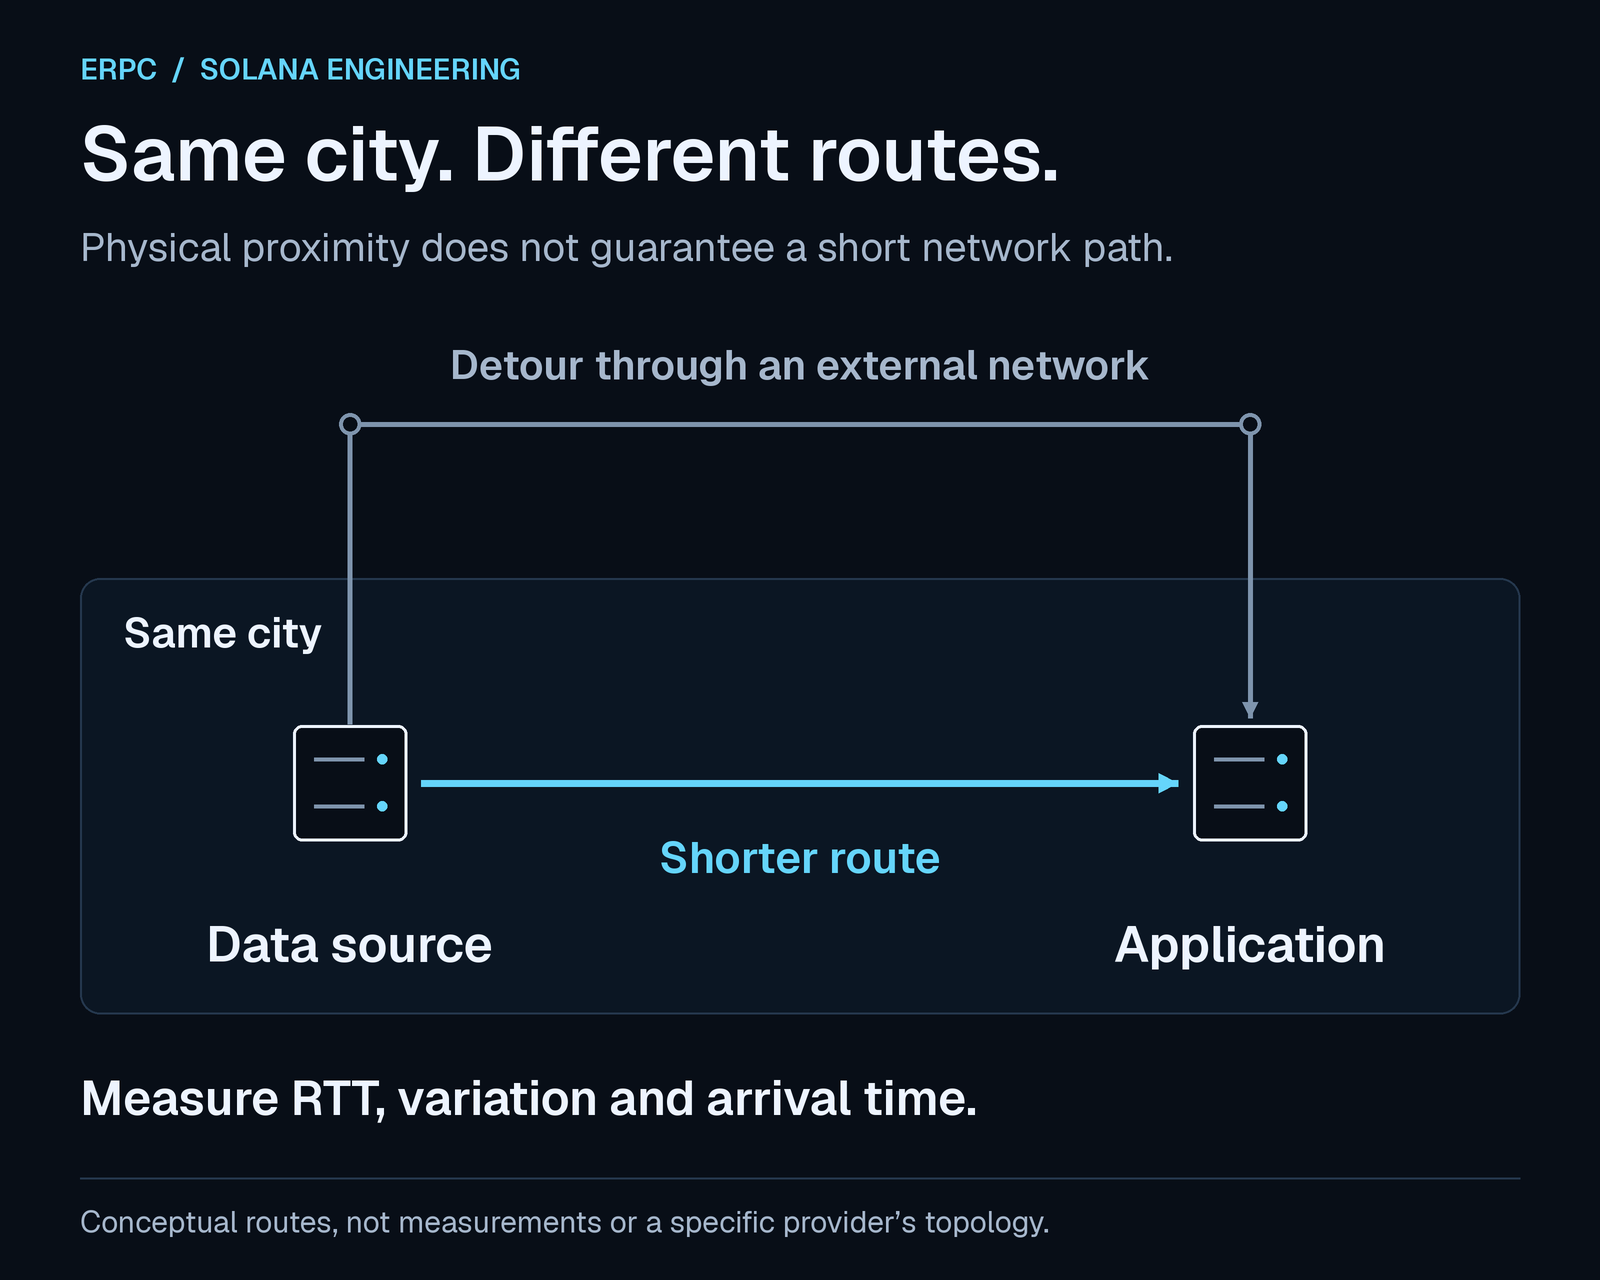
Dit diagram verklaart een verschil in routering. Het toont niet het daadwerkelijke netwerk van een bepaalde aanbieder.
Mythe 3: Een hoge netwerkspecificatie betekent voldoende bruikbare bandbreedte
Bandbreedte in een serverspecificatie kan verschillende dingen betekenen: fysieke poortsnelheid, bandbreedte toegewezen aan een virtuele machine, continu beschikbare bandbreedte of een tijdelijke pieklimiet. Een snelle NIC betekent niet dat je applicatie voortdurend de volledige capaciteit kan gebruiken.
De documentatie van AWS maakt bijvoorbeeld onderscheid tussen basisbandbreedte en burst-bandbreedte en beschrijft beperkingen rond verkeersbestemmingen, flows en pakketsnelheden. Dit illustreert hoe je een specificatie leest; het betekent niet dat iedere VPS dezelfde limieten heeft als AWS. [2]
Controleer bij het kiezen van een plan of de bandbreedte exclusief of gedeeld is, wat de voorwaarden voor continu gebruik zijn, welke overdrachtslimieten gelden en of verschillende bestemmingen anders worden behandeld. Houd tijdens een test verkeer naar hetzelfde endpoint en onder dezelfde subscriptionvoorwaarden als in productie aan. Bekijk daarbij tegelijk de ontvangstsnelheid, drops, hertransmissies en CPU-belasting.
Een hoge score in een korte snelheidstest bewijst niet dat de server een productiestream continu kan verwerken. Een lage ontvangstsnelheid betekent tegelijkertijd niet noodzakelijk te weinig bandbreedte. Onderzoek ontvangstinstellingen en verwerkingsbeperkingen afzonderlijk voordat je de verbinding opwaardeert.
Mythe 4: Een beter CPU-model, meer cores of meer maximale GHz maakt de applicatie snel
De maximale boostfrequentie van een CPU is geen kloksnelheid die hij onder iedere belasting vasthoudt. Het daadwerkelijke gedrag hangt af van vermogen, temperatuur, firmware, frequentieregeling en andere workloads. De Linux-documentatie legt uit dat het inschakelen van boost het gebruik ervan toestaat; het bewijst niet dat de CPU daadwerkelijk in boost draait. [3]
Als belangrijk werk in één thread plaatsvindt, maken extra cores dat werk op zichzelf niet sneller klaar. De totale CPU-belasting kan laag lijken terwijl één core of event loop verzadigd is. De officiële Node.js-handleiding legt eveneens uit hoe een zware callback ander werk laat wachten. [4]
Controleer kloksnelheid, temperatuur, gebruik per core en verwerkingstijden onder de werkelijke belasting. In een virtuele omgeving kan ook de tijd waarin op CPU-toewijzing wordt gewacht nuttige informatie geven. Profileer de applicatie om te bepalen hoeveel tijd naar decoderen, berekeningen, geheugentoewijzing en logging gaat.
Kies een combinatie van CPU-klokprestaties, resourcetoewijzing, instellingen voor duurzame prestaties en applicatie-implementatie. Alleen modelnummers vergelijken bepaalt niet hoe snel de hele applicatie werkt.
Mythe 5: Bij gRPC zijn de standaardinstellingen van de client voldoende
Een gRPC-verbinding tot stand brengen bewijst niet dat deze het vereiste datavolume met de vereiste snelheid kan ontvangen. HTTP/2 gebruikt flow control waarmee de ontvanger aan de afzender aangeeft hoeveel gegevens hij kan accepteren. Deze regeling geldt zowel per stream als per verbinding. Ontvangstvensters en hun updates kunnen daarom de doorvoer beperken, ook als de netwerkverbinding nog capaciteit over heeft. [5][6]
Een ontvangstvenster vertelt de afzender hoeveel gegevens hij mag verzenden zonder een nieuwe update van de ontvanger. Beginwaarden, automatische aanpassing en de voorrang van instellingen verschillen per SDK en bibliotheek. Een groot getal in een configuratiebestand zetten bewijst niet dat de client zich gedraagt zoals bedoeld. Controleer zowel stream- als verbindingsinstellingen, hun samenhang met adaptieve instellingen en de gebruikte versie.
Voer wijzigingen door terwijl je de daadwerkelijke ontvangstsnelheid en verwerkingsachterstand onder dezelfde subscriptionvoorwaarden meet. De maximale grootte van een te ontvangen bericht, de TCP-ontvangstbuffer en het HTTP/2-ontvangstvenster zijn afzonderlijke instellingen. Keepalive controleert of een verbinding nog leeft; het voegt geen verwerkingscapaciteit of bandbreedte toe.
De gRPC-FAQ van ERPC bevat stappen voor probleemonderzoek en clientconfiguratievoorbeelden voor een stream waarvan de doorvoer gelijk blijft terwijl de achterstand groeit. Gebruik de voorbeelden als vertrekpunt en controleer ze vervolgens voor je eigen subscriptionvolume en verwerkingscapaciteit. [7]
Mythe 6: Elk volledig blok ontvangen leidt tot de vroegste beslissingen
“Eerst alles ontvangen, daarna zoeken wat belangrijk is.” Dat is een begrijpelijke manier om met ontwikkelen te beginnen, maar voegt werk toe dat vóór een beslissing misschien niet nodig is. Onnodige gegevens overdragen, decoderen, van geheugen voorzien en doorzoeken verbruikt allemaal eindige bandbreedte en CPU-resources.
Wil je reageren op veranderingen in een specifieke markt, een programma of een account, definieer dan eerst de events en velden die de beslissing nodig heeft. Yellowstone gRPC biedt subscriptionfilters voor transacties en accounts en een manier om slechts een deel van accountgegevens op te halen. Meldingen voor volledige blokken verschillen bovendien van meldingen voor individuele updates. [8]
Als onder dezelfde omstandigheden en met dezelfde resources de ene applicatie alle records moet decoderen en doorzoeken terwijl de andere direct de benodigde update kan verwerken, vermijdt de tweede die wachttijd. Een gerichter werkende concurrent kan herhaaldelijk eerder reageren om redenen die verder gaan dan de netwerkverbinding. Bepalen wat je kunt negeren is onderdeel van ontwerpen voor lage latency.
Indexering, audits, onderzoek en historische opslag kunnen terecht alle gegevens vereisen. Maak daarvoor een afzonderlijk verwerkingspad. Door dit van onmiddellijke besluitvorming te scheiden, kun je voor elk pad de vereiste capaciteit en volledigheid ontwerpen. Controleer wel dat filtering geen updates verwijdert die nodig zijn voor juiste beslissingen. Batchverwerking kan in sommige gevallen de totale doorvoer verhogen. Kies deze daarom op basis van de wachttijd die de applicatie verdraagt.
Bij de huidige Shared gRPC-dienst van ERPC vereist een niet-lege
blocks-subscription Dedicated-dienstverlening. transactions-subscriptions of blocksMeta kunnen een bepaalde behoefte invullen, maar leveren geen van beide dezelfde gegevens als volledige blokken. Ook met Dedicated zijn passende verwerkingscapaciteit aan de ontvangstkant en een goed subscriptionontwerp nodig. [9]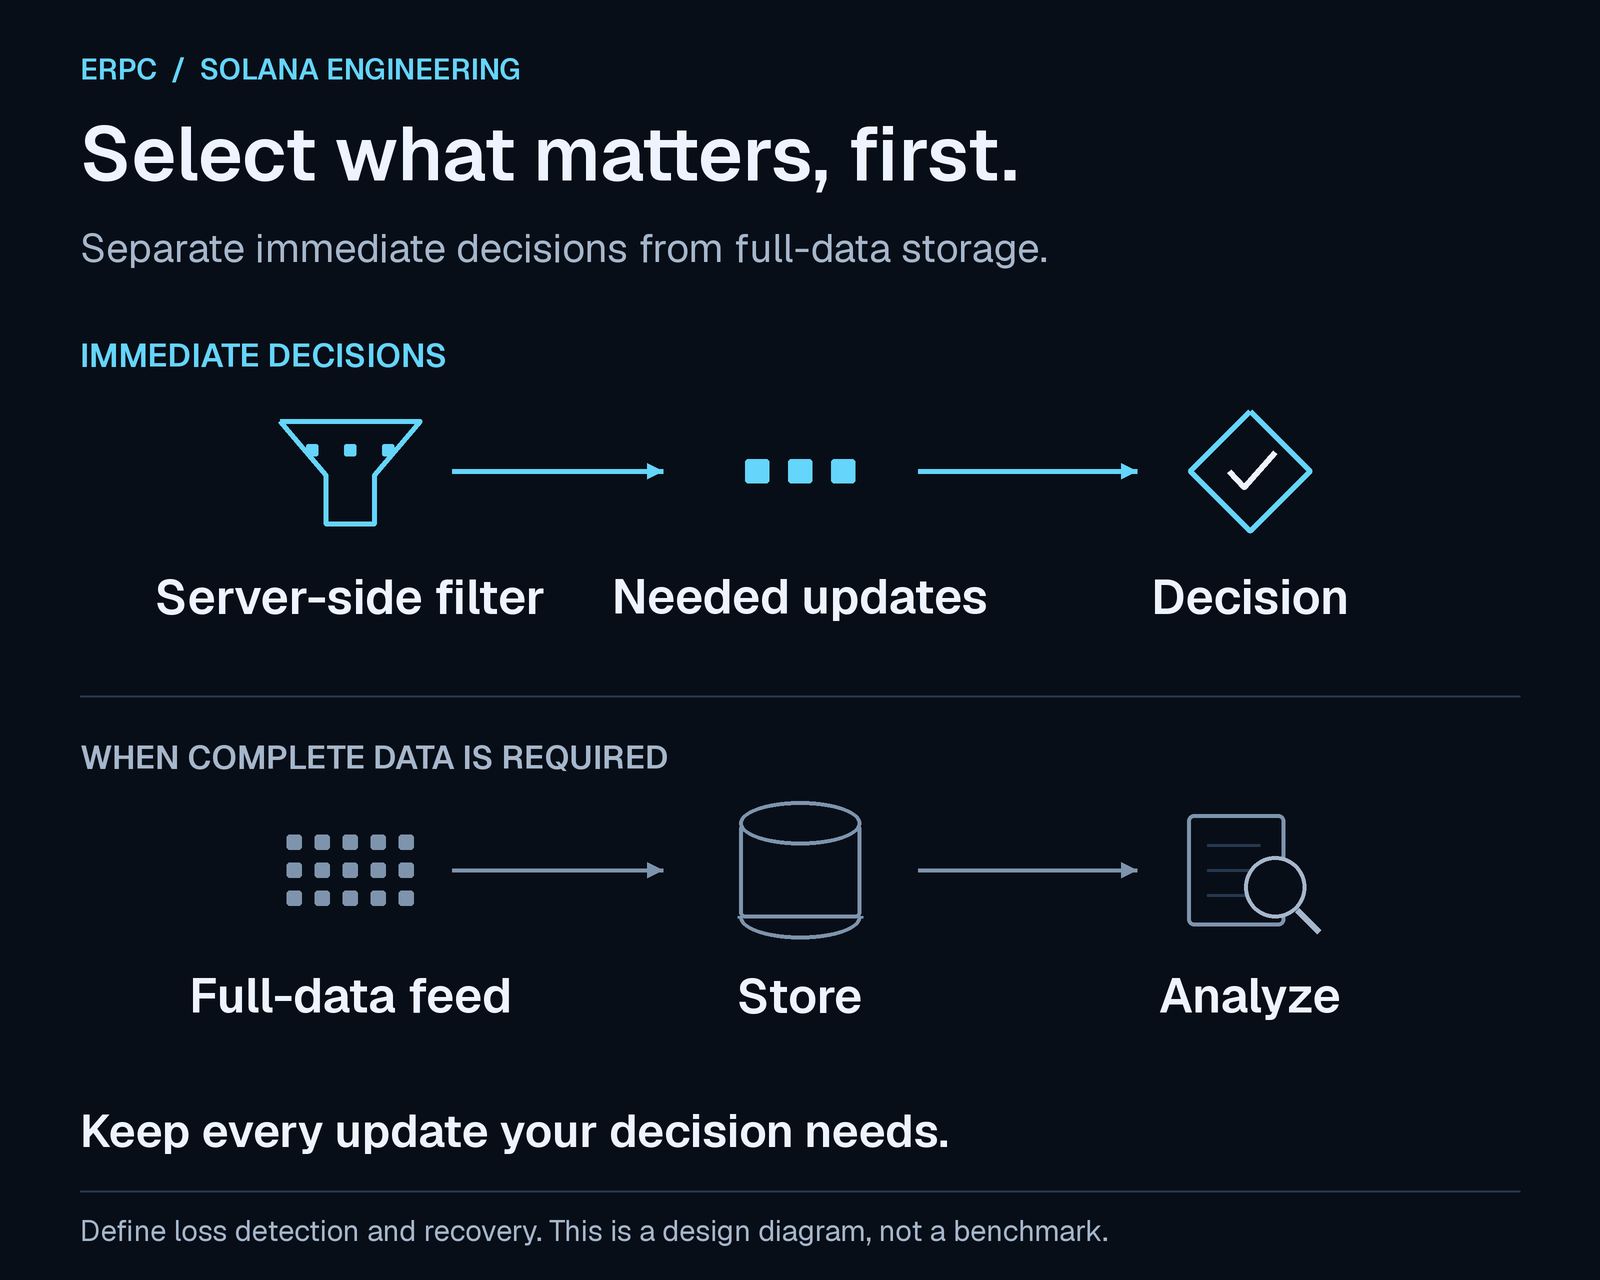
Dit diagram illustreert een architectuurkeuze. Definieer bij het beperken van subscriptions zowel de benodigde beslisinformatie als het herstel bij ontbrekende gegevens.
Mythe 7: Als gegevens binnenkomen, houdt de verwerking ze bij
Er kan een wachtrij ontstaan tussen ontvangen gegevens en gegevens die zover zijn verwerkt dat ze een beslissing ondersteunen. Als het binnenkomende werk voortdurend de verwerkingscapaciteit overschrijdt, groeit de achterstand ook terwijl de verbinding open blijft. Een grotere buffer kan tijdelijke pieken opvangen, maar bewaart bij een aanhoudend capaciteitstekort alleen meer oude gegevens.
Meet niet alleen het aantal ontvangen events. Meet ook de afgeronde verwerking, wachtrijlengte, ouderdom van het oudste onverwerkte item en de tijd van ontvangst tot het einde van een beslissing. Bewaak verbindingsgezondheid en actualiteit van gegevens afzonderlijk.
Laat in de ontvangstlus alleen werk staan dat nodig is om te blijven ontvangen. Overweeg databaseschrijfacties, volledige payloadlogging, externe API-aanroepen en zware berekeningen naar andere verwerkingspaden te verplaatsen. Geef wachtrijen een capaciteitslimiet en een beleid voor wanneer ze vol zijn. Een begrensde wachtrij kan eerder werk alsnog laten wachten zodra hij volloopt; hij lost onvoldoende verwerkingscapaciteit niet op zichzelf op. [10]
Bij updates waarvoor alleen de nieuwste toestand telt, kan het mogelijk zijn oudere toestanden samen te voegen. Transactie-events die in volgorde of volledig moeten worden verwerkt, mogen niet zonder onderscheid worden weggegooid. Ontwerp detectie van ontbrekende gegevens, opnieuw ophalen en toestandherstel na herverbinding volgens de vereisten van de applicatie.
ERPC's
STREAM_GUARD_SLOW_READER is een beschermingsreactie op onvoldoende voortgang bij het schrijven of waargenomen leveringsvertraging. Leid uit die waarneming alleen geen oorzaak af. Onderzoek de verbinding, host, subscriptionomvang en het verwerkingstempo van de applicatie. Bewaar vóór opnieuw verbinden de eerste status, message, metadata en trailers, voor zover beschikbaar. Lees daarna de reden en herhaalvoorwaarden die de server geeft. Hetzelfde afgewezen verzoek opnieuw versturen zonder correctie laat de oorzaak bestaan. [7]Mythe 8: Een snelle ping of een snel gemiddelde betekent snelheid wanneer het ertoe doet
Ping geeft een indicatie van de heen-en-terugtijd over het netwerk. Het meet een ander interval dan applicatielatency, die ook bronverwerking, subscriptioninhoud, wachten op ontvangst, decoderen en besluitvorming omvat. Een gemiddelde kan bovendien een klein aantal forse vertragingen verbergen.
p50 is de mediaan. p95 en p99 geven de punten aan waarop respectievelijk 95% en 99% van de meetwaarden op of onder die waarde ligt. p99 is niet het maximum. Vermeld het aantal metingen en de meetperiode en controleer waarden tijdens eventpieken, maxima, time-outs, verbroken verbindingen en ontbrekende gegevens. [11]
Vergelijk bij verschillende aanbieders hetzelfde event, hetzelfde datatype, commitment en dezelfde subscriptionvoorwaarden. Ontvang waar mogelijk op dezelfde meethost en gebruik voor verstreken tijd binnen de applicatie een monotone klok. Houd bij het aftrekken van tijdstempels van verschillende hosts rekening met klokverschillen die de meting kunnen verstoren.
Alleen succesvolle events bewaren kan een configuratie waarin regelmatig gegevens ontbreken snel laten lijken. Het snelste afzonderlijke resultaat kiezen is een andere beslissing dan een configuratie kiezen die minder snel achterloopt wanneer productie daarom vraagt.
Mythe 9: De vroegste gegevens zijn even definitief en betekenen hetzelfde
Shreds, transactiemeldingen, accountupdates en blokmeldingen vertegenwoordigen niet dezelfde informatie in dezelfde fase. Gegevens uit een vroegere fase gebruiken kan betekenen dat je applicatie zelf meer reconstructie of interpretatie moet uitvoeren. Een vergelijking moet daarom niet alleen de ontvangsttijd gelijkwaardig maken, maar ook wat er op dat moment bekend kan zijn. [8][12]
Maak ook onderscheid tussen Solana's commitmentniveaus
processed, confirmed en finalized. Als vroege waarnemingen beslissingen voeden, moet de applicatie later de bevestigingstoestand controleren en waar nodig haar toestand corrigeren. Scheid het ontvangen van een vroege update van de voorwaarden om een definitieve handeling in een extern systeem uit te voeren. [13]Meldingen met verschillende commitments simpelweg vergelijken en stellen dat de ene een bepaald aantal milliseconden sneller is, vergelijkt bijvoorbeeld niet hetzelfde werk. Bepaal de informatie en finaliteit die je applicatie nodig heeft en meet hoelang het onder die voorwaarden duurt voordat een beslissing mogelijk is.
Mythe 10: Een geslaagde verzending betekent dat de transactie als eerste wordt uitgevoerd
Een geslaagd
sendTransaction-antwoord betekent dat de RPC de transactie heeft geaccepteerd. Het garandeert geen verwerking of bevestiging door het cluster. De Solana-specificatie vraagt expliciet om de status van de handtekening afzonderlijk te controleren. [14]Zelfs als inkomende informatie een vroege beslissing mogelijk maakt, blijven het verzendpad, de geldigheid van de blockhash, concurrentie op beschrijfbare accounts, rekenresources, prioriteitskosten en de eigen succesvoorwaarden van de transactie van belang. SWQoS gaat over toelating en verbindingsprioriteit richting de leader, terwijl prioriteitskosten de prioriteit bij planning beïnvloeden. Ze hebben verschillende rollen en geen van beide garandeert onvoorwaardelijk uitvoeringsvolgorde of succes. [15][16]
Leg het afronden van de beslissing, de start van verzending, RPC-acceptatie, uitvoeringsresultaten en de vereiste bevestigingstoestand afzonderlijk vast. Maak bij opnieuw proberen ook onderscheid tussen het opnieuw verzenden van een transactie met dezelfde handtekening en het maken van een nieuwe transactie, om onbedoelde dubbele handelingen te voorkomen.
Pas als je het volledige pad van ontvangst tot bevestiging kunt observeren, kun je bepalen welke verbetering je dichter bij het doel brengt.
Metingen om als eerste in te richten
Je hoeft niet alle optimalisaties tegelijk toe te passen. Begin met het vastleggen van het volgende onder consistente omstandigheden, zodat je het effect van een wijziging kunt beoordelen.
| Fase | Wat je vastlegt | Wat dit helpt vinden |
|---|---|---|
| Netwerk en ontvangst | Werkelijke ontvangstsnelheid, hertransmissies en verlies, aankomstverschillen voor hetzelfde event | Beperkingen in routering, bandbreedte en ontvangstinstellingen |
| Applicatie | Aantallen ontvangen en verwerkte events, wachtrijlengte, ouderdom van het oudste item | Aanhoudende verwerkingstekorten en opgehoopte verouderde gegevens |
| Tijd tot beslissing | p50, p95, p99 en maximale tijd van ontvangst tot afgeronde beslissing | Kostbaar werk en vertraging tijdens pieken |
| Verzending en bevestiging | Start verzending, RPC-acceptatie, handtekeningstatus, uitvoeringsfouten | Vertragingen en fouten na ontvangst |
| Vergelijkingsvoorwaarden | Regio, host, SDK en versie, subscription, commitment, periode en aantal metingen | Schijnbare verschillen door andere omstandigheden |
Bewaar een uitgangsmeting en controleer vervolgens één wijziging tegelijk op basis van de symptomen: subscriptionbereik, scheiding van verwerking, clientinstellingen en locatie of resources. Controleer bij het vergroten van een venster ook op meer geheugengebruik en achterstand. Controleer bij het beperken van een subscription dat er geen vereiste informatie verloren is gegaan.
De p99 van de totale tijd bereken je niet door de p99 van elke fase op te tellen. Bereken die uit de totale tijd voor elk gekoppeld event en gebruik fasemetingen om oorzaken te vinden. Test zowel tijdens echte eventpieken als bij gemiddelde belasting.
ERPC bereidt de infrastructuur voor, zodat ontwikkelaars hun logica kunnen verfijnen
Wanneer netwerken, servers, datalevering en clients afzonderlijk worden gekozen, kan er wachttijd tussen blijven bestaan, ook als elk goede specificaties heeft. ERPC brengt Solana-datalevering en verwerkingsomgevingen op één platform samen en vermindert het werk dat ontwikkelaars anders telkens herhalen om locaties en resources vanaf nul te kiezen.
SUPER VPS en Premium VPS specificeren hoge kloksnelheden en resourcetoewijzing zonder overcommitment. Bare Metal biedt een fysiek exclusieve machine. ERPC brengt netwerken en servers dicht bij de leveringsomgeving en richt CPU, geheugen, opslag en verbindingen in op continue verwerking. Specifieke kenmerken zijn per plan en regio beschikbaar. [17][18]
| Veelvoorkomend ontwikkelprobleem | Infrastructuur en informatie via ERPC | Wat je in de applicatie verfijnt |
|---|---|---|
| Afstand die stadsnamen niet tonen | Regio- en netwerkconfiguraties om leverings- en verwerkingsomgeving samen te kiezen | Aankomsttijden en variatie meten onder je subscriptionvoorwaarden |
| Resourceconcurrentie en duurzame prestaties | SUPER VPS en Premium VPS met hoge kloksnelheid zonder overcommitment en exclusieve Bare Metal | Kostbaar werk en seriële verwerking vinden |
| Datavolume en verbindingsmethode | gRPC, Shreds, RPC en gedeelde of exclusieve opties passend bij de workload | Benodigde events en velden definiëren |
| Ontvangstinstellingen en probleemonderzoek | Solana Stream SDK, configuratievoorbeelden, filterdocumentatie en FAQ per fout | Werkelijke instellingen, wachtrijen, herverbinding en herstel controleren |
ERPC helpt ontwikkelaars verder met infrastructuurselectie en afstelling, zodat meer tijd overblijft om te bepalen wat ze observeren, welke informatie beslissingen ondersteunt en wanneer ze verzenden. Met de juiste dienst en locatie zet een subscriptionvolume dat aansluit op de verwerkingscapaciteit infrastructuurprestaties om in applicatiesnelheid.
Bepaal eerst welke informatie je beslissingen werkelijk vereisen. Ontvang die vroeg, verwerk haar zonder onnodig wachten en controleer de uitkomst. ERPC blijft de omgeving en informatie bieden om die verbetering te ondersteunen.
Hulpmiddelen voor implementatie
- ERPC gRPC-FAQ: https://erpc.global/nl/faq/grpc/general/
- Subscriptionfilters en huidige Shared-limieten: https://erpc.global/nl/doc/geyser-grpc/filter/
- Best practices voor gRPC-implementatie: https://erpc.global/nl/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/nl/vps/
- ERPC Bare Metal: https://erpc.global/nl/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Officiële Discord van Validators DAO: https://discord.gg/C7ZQSrCkYR
Technische bronnen
- RIPE IPmap, inefficiënte routes visualiseren: https://ipmap.ripe.net/
- AWS, netwerkbandbreedte van instances: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, blokkeren van de event loop voorkomen: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, HTTP/2-flow control: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, ontvangstinstellingen, slow readers en retries in de gRPC-FAQ: https://erpc.global/nl/faq/grpc/general/
- Yellowstone gRPC, specificaties voor subscriptions en filters: https://github.com/rpcpool/yellowstone-grpc
- ERPC, huidige Shared-filterregels: https://erpc.global/nl/doc/geyser-grpc/filter/
- Tokio, wachtrijen en backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, definities van percentielen: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/nl/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, transactiekosten: https://solana.com/docs/core/fees
- ERPC, VPS-configuraties en specificaties: https://erpc.global/nl/vps/
- ERPC, Bare Metal-configuraties en specificaties: https://erpc.global/nl/baremetal/