Solana高速処理を阻む10の「幻」。速いはずの環境で遅くなる理由
回線は速い。CPUも新しい。配信元と同じ都市にサーバーを置いた。それでも、必要な情報に反応するのが遅い。接続は切れていないのに、処理しているデータは少しずつ古くなっていく。
Solanaで低遅延のアプリケーションを開発するとき、こうした状況は一つの原因だけで起きるとは限りません。通信経路、受信設定、購読するデータ、アプリケーション内部の待ち時間が重なり、せっかく選んだ高速な基盤を使い切れなくなることがあります。
ELSOUL LABO B.V.が運営するERPCのサポートでも、受信ループの停滞、クライアント設定、必要以上に広い購読、エラーを解消しないままの再接続といった相談に繰り返し向き合っています。一般的なWebアプリケーションでは目立たなかった選択が、高頻度取引やリアルタイム処理では制約になります。
この記事では、その背景にある10の「幻」を整理します。目的は、速い環境の選び方と、その性能を判断・送信まで届ける設計を、自分で点検できるようになることです。
まず「何が終わるまでの時間」を短くしたいのか決める
ネットワークの往復時間、データの到着時間、判断にかかる時間、取引が確認されるまでの時間は、別の指標です。pingが速くても受信後の処理が詰まっていれば、判断は遅れます。RPCの応答が速くても、その取引が実行されたとは限りません。
最初に、自分の目的を「対象イベントを観測してから、必要な判断を終えて送信するまで」のように定義します。その上で、観測、受信後の処理、送信と確認を分けて測ります。速さを一つの製品名や一つの数値に置き換えないことが、改善の出発点です。
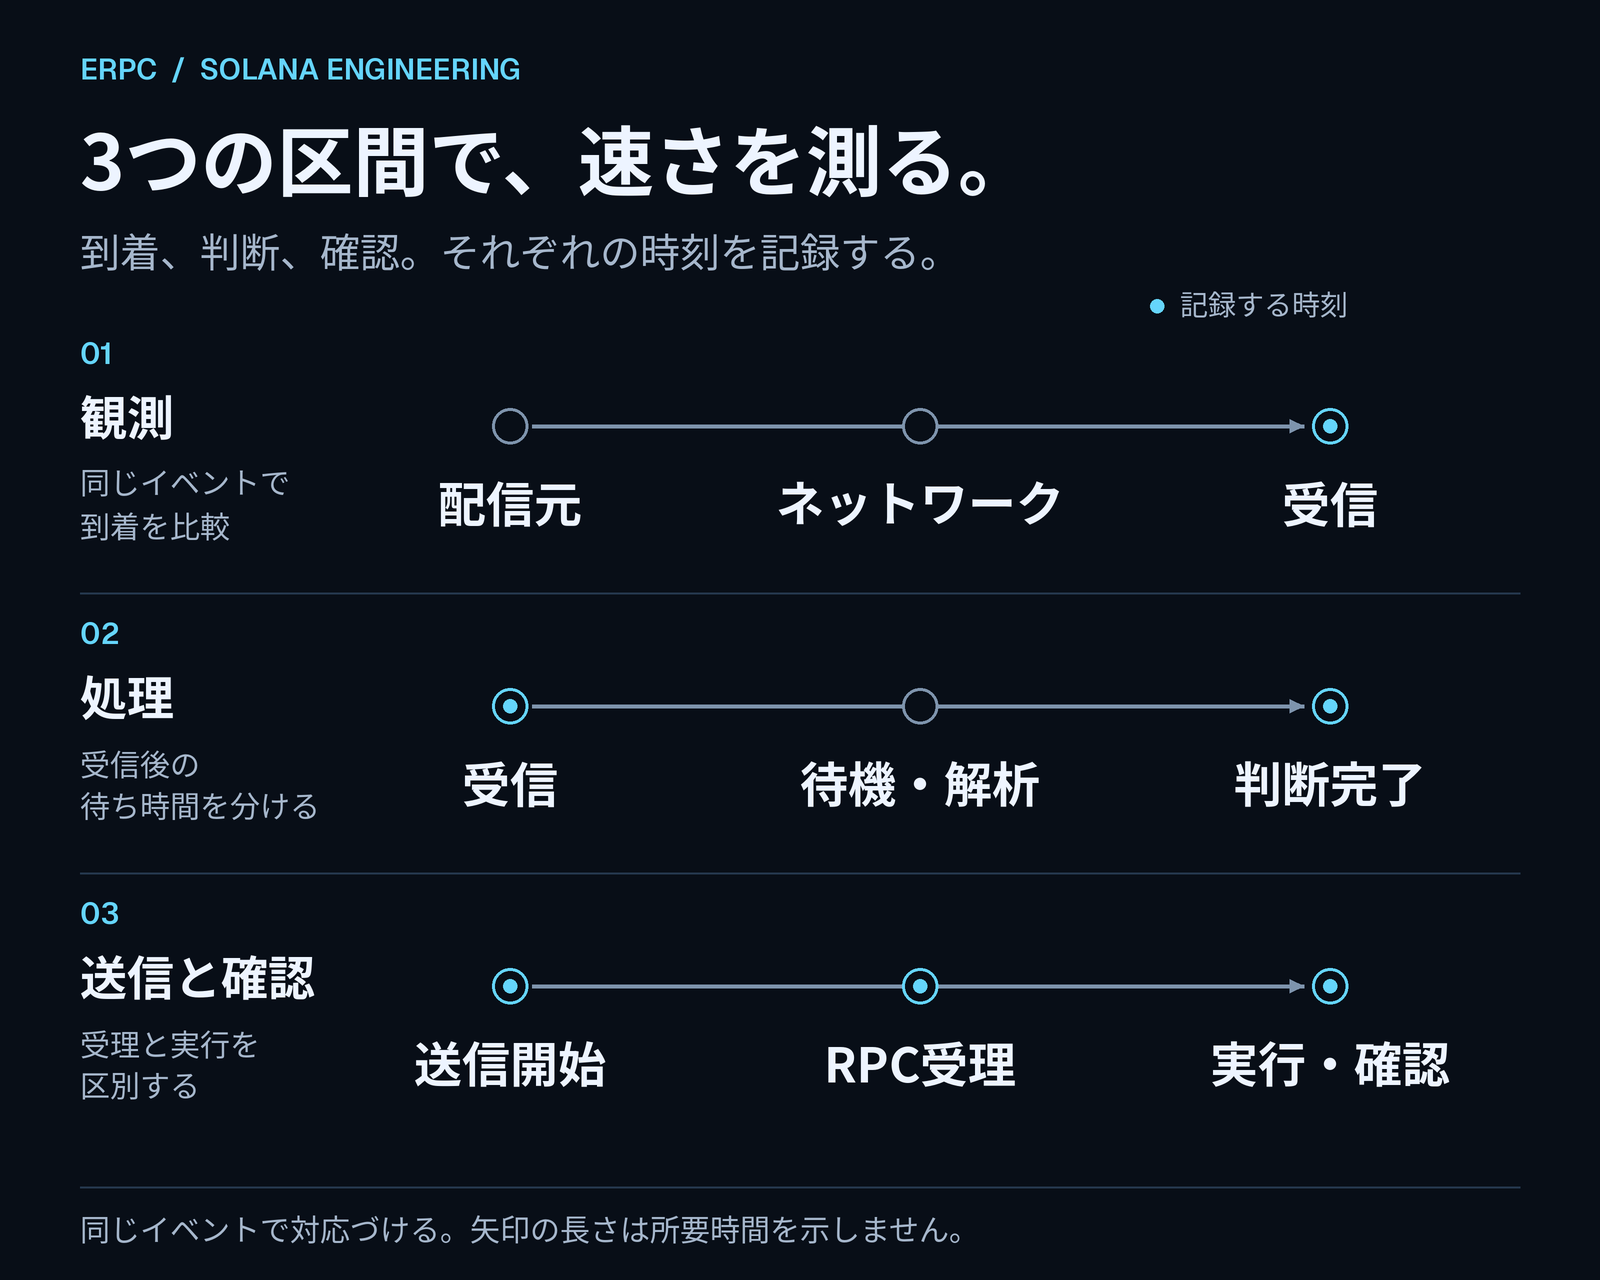
図は測定区間の模式図です。各区間の長さや性能差を示す実測ではありません。
幻1:小さなVMで動いているから、必要な性能は足りている
以前のWebアプリケーションや、Ethereumで使っていた小さなクラウドVMが問題なく動いていた。その経験から、Solanaのストリームも同じ構成で処理できると考えてしまうことがあります。しかし、少量のRPC照会を扱うアプリケーションと、広い範囲の更新を絶えず受信・処理するアプリケーションでは、必要な資源が異なります。
資源を決める基準は、扱うデータ量、到着頻度、1件当たりの処理内容、許容する遅延です。毎秒何件のイベントを受け取り、何bytesを転送し、デコードと判断にどれだけCPUとメモリを使うのか。通常時に加え、イベントが集中する場面で処理が追いつく余裕を見積もります。同じチェーンでも、購読範囲と実装によって必要量は変わります。
厄介なのは、資源が足りなくても、動いているように見えることです。画面にはデータが出続けていても、その内容が過去のものになっていたり、再接続の間の欠落を検知できていなかったりします。受信した件数だけでは分からないため、処理完了件数、未処理データの古さ、対象イベントの連続性を確認します。
以前の経験だけを基準にすると、受信側の限界を疑う機会がなく、配信エンドポイントの問題だと考え続けることがあります。余裕のある環境を試して初めて、今まで見えていなかった滞留や欠落に気づく場合もあります。
切り分けには、同じエンドポイント、購読、commitment、SDKと設定、処理内容を、余裕のある受信・処理環境で比較します。地域を揃え、CPU・メモリ・ネットワーク条件の違いを記録し、受信量、処理完了量、滞留、欠落、判断までの時間がどう変わるかを見ます。時間帯によって負荷が変わるため、可能なら同時間帯で比較し、接続上限と配信負荷にも配慮します。
環境を変えて改善したなら、受信・処理環境が結果に影響していたことが分かります。CPU、メモリ、ネットワークを同時に変えた場合は、どの資源が効いたかをさらに確かめます。実際に受け取る量と流れる速さに合わせて構成を選ぶことが、低遅延処理の前提です。
幻2:同じ都市なら、ネットワークでも近い
「Frankfurt同士だから近い」「Tokyoに置けば日本向けには最速」。都市名は配置を考える手がかりになりますが、実際の通信経路を保証するものではありません。
データが通る道は、データセンター間の接続、通信事業者間の接続、経路選択によって変わります。同じ都市のサーバー同士でも外部のネットワークを経由して遠回りすることがあります。RIPEのIPmapも、国を出て再び戻るような経路の非効率を可視化する用途を挙げています。[1]
確認するのは、実際の配信元と処理環境の間のRTT、時間帯による変動、再送や欠損、そして同じイベントが届く時刻です。tracerouteやMTRは経路を調べる手がかりになりますが、ホップ数だけで優劣は決められません。中間ルーターの応答制限を、アプリケーションのパケット損失と即断しないことも大切です。
リージョンを選んだ後に、「この配信元とこのサーバーは、実際にどうつながるのか」まで確認する。この一段深い選び方が、都市名だけで選ぶと見落とす差を明らかにします。
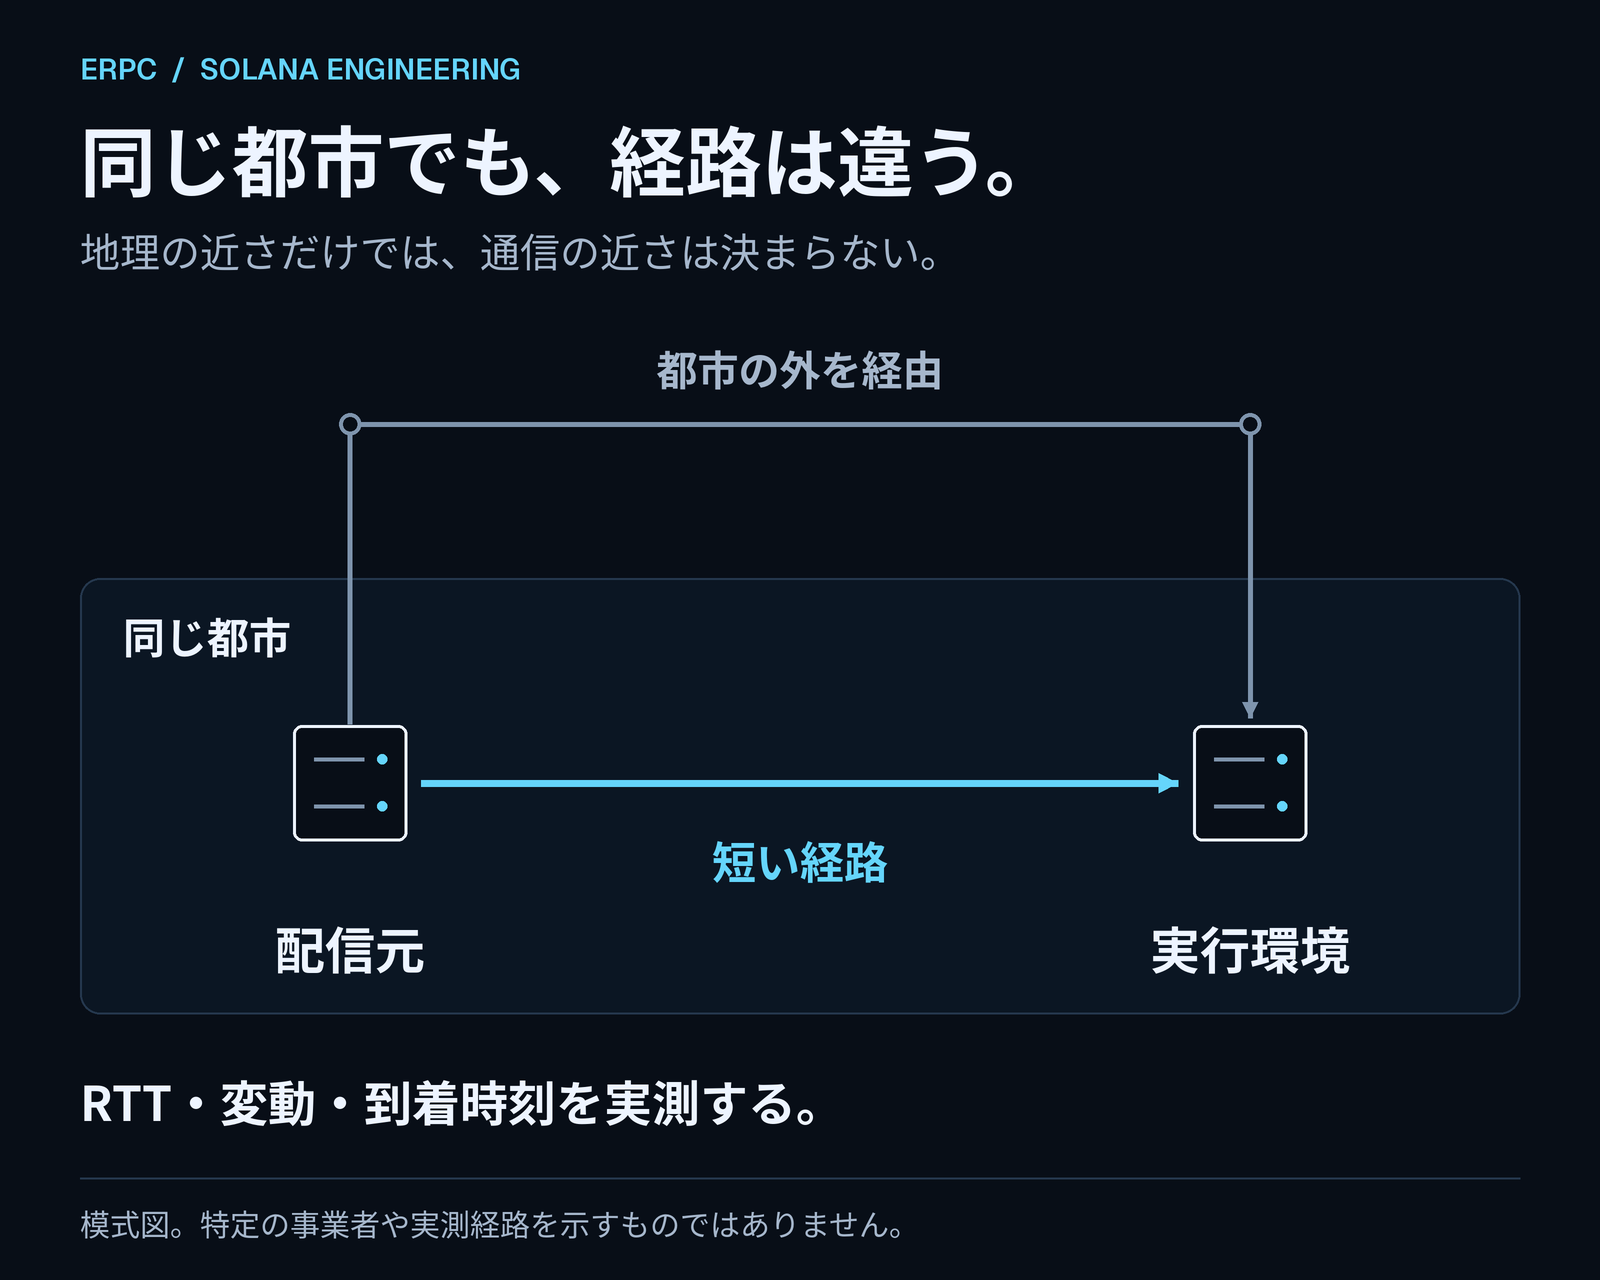
図は経路の違いを説明する模式図で、特定事業者の実際の経路ではありません。
幻3:回線のスペックが高ければ、使える帯域も十分
サーバーの仕様に書かれた帯域には、物理ポートの速度、仮想マシンに割り当てられる帯域、継続して使える帯域、一時的なバースト上限など、異なる意味があります。高速なNICがあることと、自分のアプリケーションがその帯域を継続して使えることは同じではありません。
例えばAWSの公式資料でも、baselineとburstを区別し、通信先やフロー、パケット数などによる制約を説明しています。これは仕様の読み方の例であり、すべてのVPSにAWSと同じ制限があるという意味ではありません。[2]
契約時には、帯域が専有か共有か、継続利用の条件、転送量の上限、通信先による扱いの違いを確認します。検証時には、本番と同じ接続先と購読条件で通信を続け、受信量、ドロップ、再送、CPU負荷を一緒に見ます。
短い速度テストで高い数値が出ても、本番のストリームを継続して処理できる証明にはなりません。一方で、受信量が伸びない理由が帯域不足とは限らないため、回線を増強する前に受信設定と処理速度も切り分けます。
幻4:CPUの型番、コア数、最大GHzが良ければ速い
CPUの最大ブースト周波数は、どの負荷でも維持される動作周波数ではありません。実際の動作は、電力・温度・ファームウェア・周波数制御・他の負荷などに左右されます。Linuxの公式文書でも、boostの有効化は利用を許可するもので、実際にブーストしていることを示さないと説明されています。[3]
さらに、重要な処理が一つのスレッドに集中していれば、コアを増やすだけではその処理は短くなりません。全体のCPU使用率が低く見えても、一つのコアやイベントループだけが詰まっていることがあります。重いコールバックが他の処理を待たせる問題は、Node.jsの公式ガイドでも説明されています。[4]
確認するのは、実際の負荷をかけたときの周波数、温度、コア単位の使用率、処理時間です。仮想環境では、CPUを使いたくても割り当てを待たされる時間も手がかりになります。プロファイルを取り、デコード、計算、メモリ確保、ログ出力のどこに時間を使っているかを調べます。
高クロックのCPU、資源の割り当て、継続して性能を出せる設定、アプリケーションの実装を組み合わせて選ぶことが必要です。型番の比較だけで、処理全体の速さは決まりません。
幻5:gRPCなら、クライアントは初期設定のままでよい
gRPCで接続できたことは、必要な量のデータを必要な速さで受け取れることの証明ではありません。HTTP/2には、受信側が受け取れる量を送信側に知らせるフロー制御があります。ストリーム単位と接続単位の両方で制御されるため、回線が空いていても、受信窓やその更新が流量を制約することがあります。[5][6]
ここでいう受信窓は、受信側が「追加の通知なしに送ってよい」と伝えるデータ量の枠です。SDKやライブラリによって初期値、自動調整の有無、設定の優先順位が異なります。設定ファイルに大きな数値を書いただけで、意図した動作になったとは限りません。streamとconnectionの両方、adaptive設定との関係、使っているバージョンを確認します。
改善は、同じ購読条件で実効受信量と処理待ちを測りながら行います。メッセージの最大受信サイズ、TCPの受信バッファ、HTTP/2の受信窓は、それぞれ別の設定です。keepaliveも接続の生存確認の仕組みであり、処理能力や帯域を増やす機能ではありません。
ERPCのgRPC FAQには、流量が一定のまま遅れていく場合の切り分け手順とクライアント設定例があります。推奨例を出発点に、自分の購読量と処理能力で確認することが大切です。[7]
幻6:ブロックを全部受け取れば、最も早く判断できる
「まず全部受け取って、後から必要なものを探す」。開発を始めるには分かりやすい方法ですが、判断までに必要のない仕事も増やします。不要なデータの転送、デコード、メモリ確保、検索が、有限の帯域とCPUを使うためです。
特定の市場、プログラム、アカウントの変化に反応したいのであれば、判断に必要なイベントとフィールドを先に定義します。Yellowstone gRPCには、トランザクションやアカウントの購読フィルタ、アカウントデータの一部を取得する仕組みがあります。ブロック全体の通知と、個々の更新の通知も別のものです。[8]
同じ資源と条件で、一方が全件の展開と検索を待ち、もう一方が判断に必要な更新を先に処理できるなら、後者はその待ち時間を省けます。対象を絞った相手に繰り返し先行される原因は、回線の差だけとは限りません。何を無視してよいかを決めることも、低遅延設計の一部です。
全量取得が必要な索引、監査、研究、履歴保存には、全量を扱う経路を用意します。即時判断の経路と分離すれば、それぞれに必要な処理能力と完全性を設計できます。ただし、絞り込みによって判断に必要な更新を失っていないかは検証してください。バッチ処理も総処理量を増やせる場合があり、待ち時間の許容範囲と合わせて選びます。
ERPCの現行Shared gRPCでは、非空の
blocks購読はDedicated向けです。用途に応じてtransactions購読やblocksMetaを使えますが、これらはfull blockと同じデータではありません。Dedicatedを選ぶ場合も、受信側の処理能力と購読設計は必要です。[9]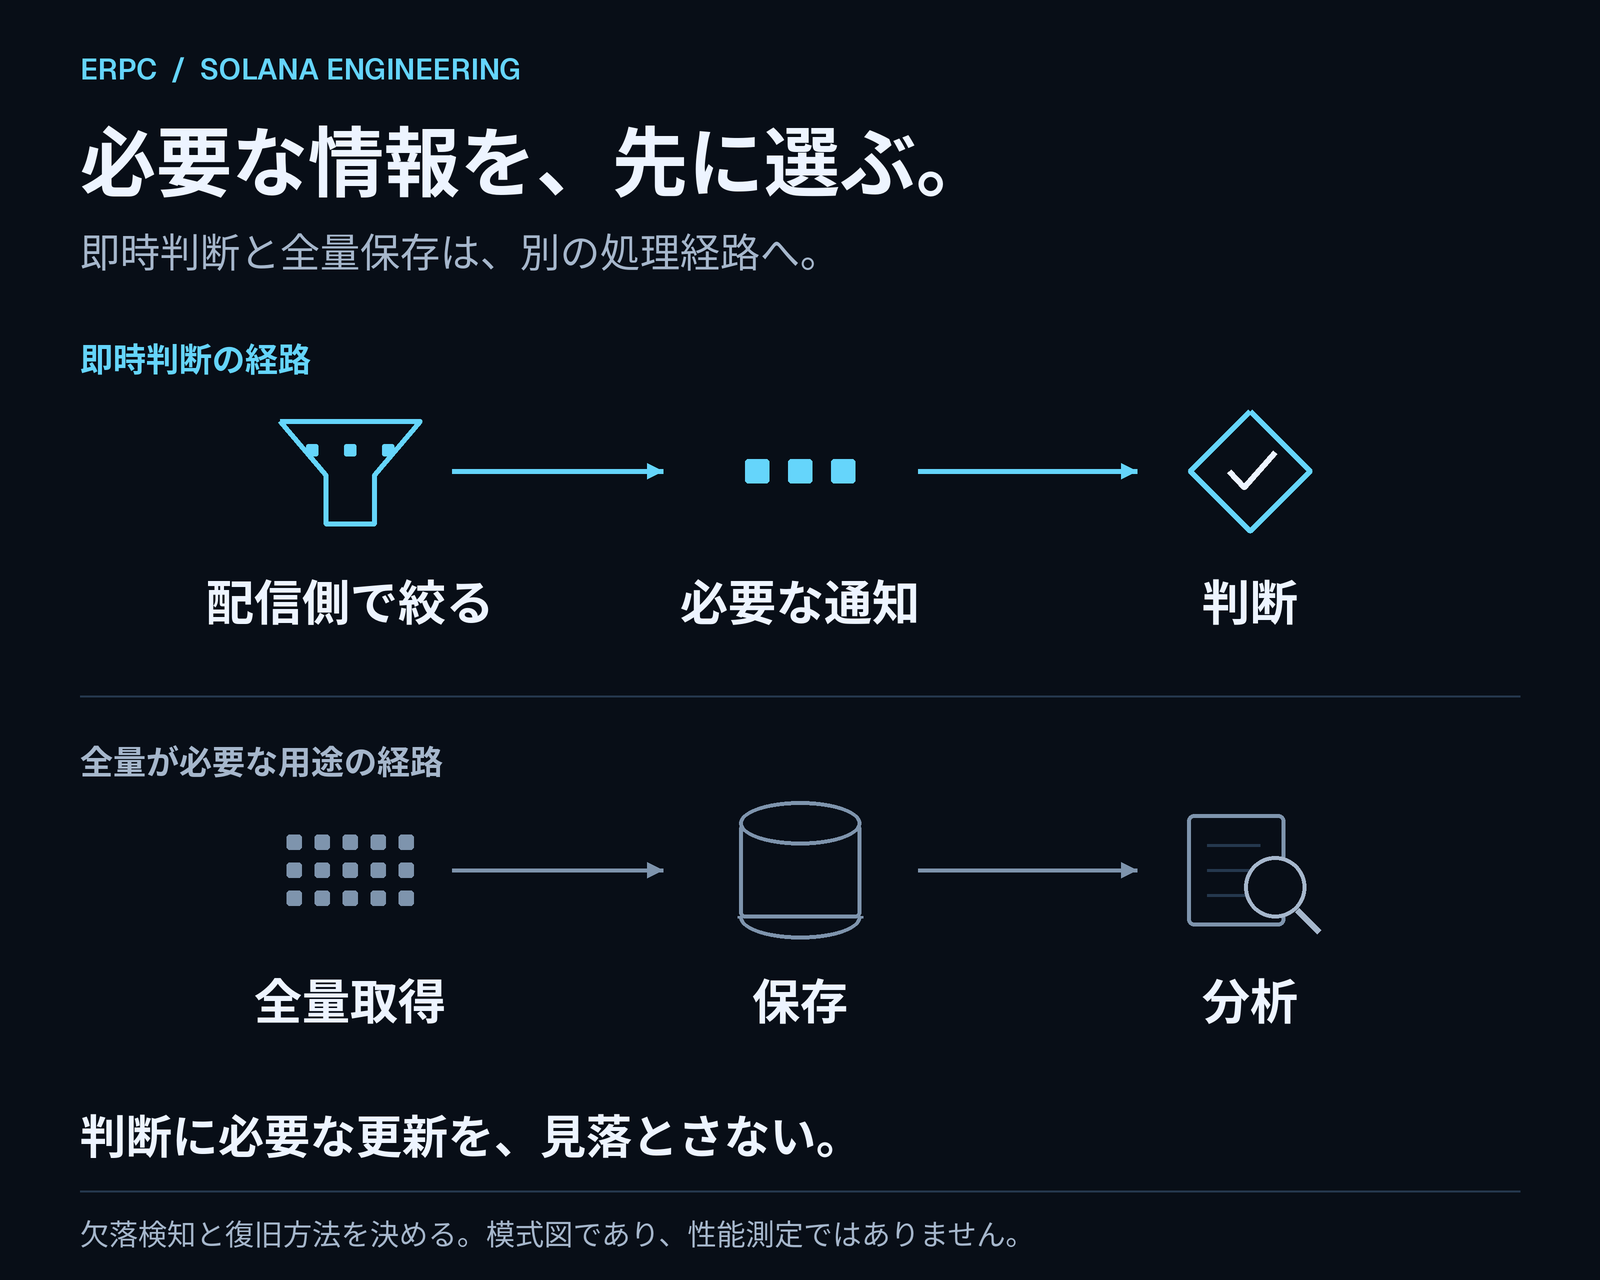
図は設計の模式図です。購読を絞る際は、判断に必要な情報と欠落時の復旧方法を定義します。
幻7:受信できていれば、処理も追いついている
受信したデータと、判断に使える状態まで処理したデータの間には、待ち行列ができることがあります。流入する仕事が処理能力を上回り続ければ、接続が維持されていても遅れは積み上がります。バッファを大きくすると、一時的な集中を吸収できる一方で、継続的な処理不足では古いデータをより多く抱え込むことになります。
見るべきなのは、受信件数だけではありません。処理完了件数、キューの長さ、最も古い未処理データの経過時間、受信から判断終了までの時間を合わせて測ります。接続の正常性と、データの鮮度を別々に監視します。
受信ループには、受信を継続するための必要最小限の仕事を置きます。DBへの書き込み、全文ログ、外部API、重い計算は、処理経路を分けられるか検討します。キューには上限と満杯時の方針を持たせます。ただし、上限付きキューも満杯になれば手前の処理を待たせるため、処理能力の不足そのものは解消しません。[10]
最新状態だけで足りる更新なら古い状態をまとめられる場合がありますが、順序や全件処理が必要な取引イベントを無条件に捨ててはいけません。欠落検知、再取得、再接続後の状態復元を、用途に応じて設計します。
ERPCの
STREAM_GUARD_SLOW_READERは、書き込みの進行不足や配信遅延を観測した際の保護動作です。これだけで原因を断定せず、回線、ホスト、購読量、アプリケーションの消費速度を切り分けます。取得できたstatus、message、metadata、trailersを再接続で上書きされる前に保存し、サーバーが示す理由と再試行条件を読みます。同じ拒否内容を直さず再送しても、原因は残ります。[7]幻8:pingや平均値が速ければ、必要な場面でも速い
pingはネットワーク往復時間の手がかりです。配信側の処理、購読内容、受信待ち、デコード、判断までを含むアプリケーションの遅延とは、測っている区間が異なります。また、平均値だけでは、少数の大きな遅れを見落とすことがあります。
p50は中央値、p95とp99は、それぞれ測定値の95%、99%が収まる位置を示します。p99は最大値ではありません。サンプル数と測定期間を添え、イベントが集中する時間の値、最大値、タイムアウト、切断、欠損も確認します。[11]
配信元を比較するときは、同じイベント、同じデータ種別、同じcommitment、同じ購読条件を対応させます。可能なら同じ計測ホストで受信し、アプリケーション内の経過時間には単調増加する時計を使います。別ホストの時刻を引き算する場合は、時計のずれが測定に混ざることにも注意が必要です。
成功したイベントだけを残すと、欠損が多い構成が速く見えることがあります。最速の一回を選ぶことと、本番の必要な場面で遅れにくい構成を選ぶことは、別の判断です。
幻9:最も早く届いたデータは、同じ意味の確定情報である
Shreds、トランザクション通知、アカウント更新、ブロック通知は、同じ段階の同じ情報ではありません。早い段階のデータを使えば、その後に自分で行う復元や解釈が増えることがあります。比較するときは、受信時刻だけでなく、その時点で何が分かるのかを揃える必要があります。[8][12]
Solanaの
processed、confirmed、finalizedも区別します。早い観測を判断に使うなら、後から確定状態を確認し、必要に応じて状態を修正する設計が必要です。速報を受け取る処理と、外部への確定的な処理を行う条件を分けます。[13]例えば、別のcommitmentで受け取った通知を単純に並べて「こちらが何ms速い」としても、同じ仕事を比較したことにはなりません。自分の用途で必要な情報と確定性を決め、その条件で判断可能になるまでの時間を測ります。
幻10:送信が成功すれば、取引も先に実行される
sendTransactionの成功応答は、RPCが取引を受け付けたことを示します。クラスタでの処理や確認を保証するものではありません。Solanaの公式仕様も、署名の状態を別に確認する必要があると説明しています。[14]受信した情報で早く判断できても、その後の送信経路、blockhashの有効性、書き込み先アカウントの競合、計算資源、優先手数料、取引自体の成否が関わります。SWQoSはリーダーへの入力や接続の優先に関わり、優先手数料はスケジューリングの優先度に関わります。役割は異なり、どちらも実行順や成功を無条件に保証する仕組みではありません。[15][16]
記録は、判断終了、送信開始、RPC受理、実行結果、必要な確認状態に分けます。再送する場合も、同じ署名の取引を再送することと、新しい取引を作り直すことを区別し、意図しない二重の処理を防ぎます。
受信から確認までが一続きに観測できて初めて、どこを改善すると目的に近づくのかが分かります。
最初に用意したい測定項目
すべての最適化を一度に行う必要はありません。まず、次の項目を同じ条件で記録できる状態にすると、変更の効果を判断しやすくなります。
| 区間 | 記録するもの | 見つけたい問題 |
|---|---|---|
| ネットワークと受信 | 実効受信量、再送・欠損、同一イベントの到着差 | 経路、帯域、受信設定の制約 |
| アプリケーション | 受信数と処理完了数、キュー長、最古データの経過時間 | 継続的な処理不足、古い情報の滞留 |
| 判断まで | 受信から判断終了までのp50・p95・p99、最大値 | 重い処理、集中時の遅延 |
| 送信と確認 | 送信開始、RPC受理、署名状態、実行エラー | 受信以降に生じる遅れや失敗 |
| 比較条件 | 地域、ホスト、SDKとバージョン、購読、commitment、期間と件数 | 条件の違いによる見かけの差 |
改善前の記録を残し、購読範囲、処理の分離、クライアント設定、配置や資源の順に、症状に合う変更を一つずつ検証します。窓を広げたらメモリと滞留が増えていないか、購読を絞ったら必要な情報を失っていないかも合わせて確認します。
総時間のp99は、各区間のp99を単純に足して求めるものではありません。同じイベントごとの総時間から計算し、区間別の測定は原因の特定に使います。平均的な負荷だけでなく、実際にイベントが集中する場面でも確かめます。
ERPCが基盤を整え、開発者がロジックを磨く
ネットワーク、サーバー、データ配信、クライアントを別々に選ぶと、それぞれが良い仕様でも、組み合わせたときに待ち時間が残ることがあります。ERPCは、Solana向けの配信と処理環境を同じプラットフォームで選べるようにし、配置や資源の選定から開発者が毎回組み立て直す負担を減らします。
SUPER VPSとPremium VPSは、高クロック構成とオーバーコミットを行わない資源設計を掲げています。Bare Metalは、物理マシンを専有する選択肢です。ネットワークとサーバーをERPCの配信環境に近づけ、CPU、メモリ、ストレージ、通信を継続的な処理に合わせて整えます。具体的な仕様は、プランと地域ごとに確認できます。[17][18]
| 開発でつまずきやすい点 | ERPCで選べる基盤・情報 | アプリケーション側で磨くこと |
|---|---|---|
| 都市名だけでは分からない距離 | 配信環境と処理環境を合わせて選ぶ地域・ネットワーク構成 | 自分の購読条件で到着と変動を測る |
| 資源の競合や持続性能 | 高クロック・オーバーコミットなしのSUPER VPSとPremium VPS、専有Bare Metal | 重い処理と直列部分を見つける |
| データ量と接続方式 | gRPC、Shreds、RPC、用途に応じた共有・専有の選択肢 | 必要なイベントとフィールドを定義する |
| 受信設定とトラブルシュート | Solana Stream SDK、設定例、フィルタ資料、エラー別FAQ | 実効設定、キュー、再接続・復旧を検証する |
ERPCを使う価値は、基盤の選択と調整を前に進めやすくし、何を観測し、どの情報で判断し、いつ送信するかという開発に時間を使えることです。適切なサービスと配置を選んだ上で、購読量と処理能力を合わせれば、インフラの性能をアプリケーションの速さにつなげられます。
最初に決めたいのは、自分の判断に本当に必要な情報です。その情報を早く受け取り、待たせずに処理し、結果まで確かめる。ERPCは、その改善を続けるための環境と情報を提供していきます。
実装に使えるリンク
- ERPC gRPC FAQ: https://erpc.global/ja/faq/grpc/general/
- 購読フィルタと現行Sharedの制限: https://erpc.global/ja/doc/geyser-grpc/filter/
- gRPCの実装ベストプラクティス: https://erpc.global/ja/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/ja/vps/
- ERPC Bare Metal: https://erpc.global/ja/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Validators DAO 公式 Discord: https://discord.gg/C7ZQSrCkYR
技術資料
- RIPE IPmap、通信経路の非効率の可視化: https://ipmap.ripe.net/
- AWS、インスタンスのネットワーク帯域: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel、CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js、イベントループをブロックしない設計: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113、HTTP/2のフロー制御: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC、Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC、gRPCの受信設定・slow reader・再試行のFAQ: https://erpc.global/ja/faq/grpc/general/
- Yellowstone gRPC、購読とフィルタの仕様: https://github.com/rpcpool/yellowstone-grpc
- ERPC、現在のSharedフィルタ規則: https://erpc.global/ja/doc/geyser-grpc/filter/
- Tokio、キューとバックプレッシャー: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch、パーセンタイルの定義: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC、Shreds UDP Forwarding: https://erpc.global/ja/doc/shredstream/udp-forwarding/
- Solana、Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana、sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana、Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana、トランザクション手数料: https://solana.com/docs/core/fees
- ERPC、VPSの構成と仕様: https://erpc.global/ja/vps/
- ERPC、Bare Metalの構成と仕様: https://erpc.global/ja/baremetal/